8 мин
Разделение контуров dev test prod в SMB: минимум без риска
Разделение контуров dev test prod для SMB: как собрать минимальную инфраструктуру, чтобы тестировать безопасно, не блокировать релизы и не переплачивать.
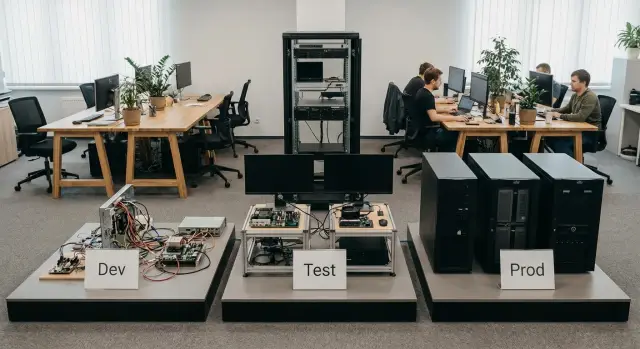
Зачем SMB вообще разделять dev, test и prod
Когда у небольшой команды одна среда на все, проблемы начинаются не из-за «сложности IT», а из-за очереди задач. Разработчик обновил библиотеку, тестировщик запускает проверку, а в это же время бухгалтерия закрывает день. Любое изменение мешает кому-то еще.
Главная беда общего контура в том, что ошибки становятся общими. Тестовые настройки попадают в боевой сервис, временный код задерживается, а «быстрые правки» делаются прямо в проде, потому что так проще. Итог - сбои и конфликты, которые съедают больше времени, чем базовая организация сред.
Обычно всплывают три риска.
- Данные: тесты случайно меняют реальные записи, а копии базы утекают «на ноутбук» без контроля.
- Доступы: один общий логин или ключи «для всех» не дают понять, кто и что сделал.
- Обновления: зависимость обновили ради одной задачи, и внезапно перестало работать то, что вчера было стабильным.
При этом разделение dev/test/prod не обязано означать три одинаковых кластера и большие затраты. Для SMB «достаточно разделить» - добиться двух вещей: чтобы эксперименты не могли повлиять на пользователей и чтобы путь изменения до продакшена был предсказуемым.
На практике роли у контуров простые:
- Dev - место, где можно ломать и быстро чинить, проверяя идеи.
- Test - место, где команда подтверждает, что все работает как задумано, в условиях близких к боевым, но без риска для реальных данных.
- Prod - среда, где важнее всего стабильность, контроль изменений и понятная ответственность.
Пример: в небольшой клинике разработчик добавляет поле в карточку пациента. В dev он меняет схему и код. В test проверяют запись и печать документов на обезличенных данных. И только потом обновление попадает в prod, не останавливая регистратуру.
Что именно должно отличаться между контурами
Чтобы разделение dev/test/prod работало, недостаточно «трех одинаковых серверов». Контуры должны отличаться в нескольких местах. Иначе тестирование будет либо опасным, либо бесполезным.
Данные
Главное правило: в test не должны жить реальные персональные и финансовые данные. Если без «похожих» данных никак, делайте обезличивание и урезайте набор. Частая практика для SMB: в test держать небольшой срез (например, 1-2% записей) без ФИО, телефонов и документов, а в dev - синтетические данные, которые можно удалить без сожаления.
Важно и то, как хранятся данные: у тестовых баз должны быть отдельные учетные записи, отдельные бэкапы и отдельные политики хранения. Тогда ошибка разработчика не превращается в инцидент.
Конфигурации и интеграции
Многие поломки после релиза - это не код, а настройки. В каждом контуре должны быть свои адреса сервисов, свои ключи и свои внешние интеграции. Для теста полезно иметь «песочницы» платежей, SMS, почты, аналитики. Если песочницы нет, лучше отключить интеграцию в test, чем случайно отправить клиентам реальные уведомления.
Доступы и наблюдаемость
Права стоит разнести так, чтобы прод не превращался в «общую песочницу».
- Деплой в prod делают 1-2 ответственных человека.
- Логи prod доступны только тем, кому они нужны для поддержки.
- В dev разработчики могут свободно экспериментировать без риска для бизнеса.
- Доступ к базам выдается по задаче и на ограниченное время.
Надежность и «что переживает перезапуск»
В prod должно быть ясно, что сохраняется всегда: база, файлы, очереди, ключи, настройки. В dev допустимы быстрые пересоздания. Но test должен быть ближе к prod по поведению: перезапуск, обновление, откат - без потери данных и без ручной магии.
Простой пример: интернет-магазин SMB тестирует новую скидку. В dev разработчик гоняет логику на синтетике. В test проверяют сценарий «оформление заказа» на обезличенной базе и с тестовым платежным шлюзом. В prod включают фичу только после того, как подтверждены доступы, ключи и мониторинг.
Варианты минимальной инфраструктуры без лишних затрат
Разделение dev/test/prod не обязано начинаться с дорогого кластера. Для SMB важнее быстро получить изоляцию, чтобы тестировать безопасно, и при этом не усложнить жизнь команде.
Самый простой старт: один хост и 2-3 ВМ
Частый минимум - один сервер виртуализации и несколько виртуальных машин: dev, test и prod (иногда dev и test объединяют, если изменений мало). Это дешево и понятно: разные ВМ, разные сети, разные доступы. Минус очевиден: если хост на обслуживании или сломался, останавливается все.
Чуть надежнее: два хоста без «настоящего» кластера
Если простой неприемлем, добавьте второй хост. Не обязательно строить сложную отказоустойчивость с первых дней. Достаточно договориться о правилах: prod живет на основном хосте, dev и test - на втором, а при работах вы переносите ВМ вручную по плану. Это спасает, когда нужно обновить гипервизор, заменить диск или провести диагностику.
Контейнеры подходят, когда приложение stateless, а состояние вынесено в отдельную базу или сервис хранения. Тогда dev и test можно поднимать быстро и дешево. Но отдельные ВМ обычно лучше, если у вас конфликтуют версии ОС или зависимостей, база данных тяжелая и нужна предсказуемая производительность, есть требования по изоляции (например, test не должен видеть prod-сеть) или много легаси-сервисов, которые сложно контейнеризировать.
Что можно разделять строго, а что можно оставить общим
Общее допустимо там, где нет риска утечки данных и случайного воздействия на prod. Например, можно оставить единый мониторинг и централизованные логи, но с отдельными правами и четкими метками окружений.
Нельзя делать общими продовую базу и секреты. Даже если тесту нужны «похожие» данные, лучше отдельная тестовая БД и отдельные ключи. Реальный сценарий: бухгалтерия просит срочную правку отчета, разработчик тестирует на общей базе и случайно запускает миграцию. При раздельных контурах это становится просто невозможным.
Если вы выбираете железо под такой старт, обычно хватает одного-двух серверов среднего класса с запасом по памяти и быстрыми дисками. Для компаний в Казахстане часто удобно, когда поставщик может собрать серверы, развернуть виртуализацию и дальше поддерживать инфраструктуру 24/7, чтобы команда не тратила время на «железные» задачи.
Пошагово: как настроить разделение контуров за 1-2 недели
Если команда небольшая, важно не усложнять. Цель - сделать так, чтобы тестирование было похоже на боевую среду, а prod при этом оставался закрытым и предсказуемым.
План на 1-2 недели
Начните с сетевого разделения. Идеально - отдельные подсети или VLAN для dev, test и prod. Если сетевое оборудование пока не позволяет, сделайте минимум через правила фаервола: запретите прямые входы в prod из офисной сети и из dev/test, оставив только нужные порты и источники.
Дальше поднимите три окружения как отдельные наборы ресурсов: базы, очереди, хранилища, конфиги. Dev может быть легче (меньше ресурсов), test должен быть максимально похож на prod по настройкам, а prod - только для пользователей и ограниченного числа админов.
Практический порядок работ:
- День 1-2: описать, какие сервисы входят в систему, и какие порты реально нужны между ними.
- День 3-4: развести сеть (VLAN/подсети или фаервол) и включить доступ в prod только через VPN или отдельную админ-точку.
- День 5-7: поднять dev и test как отдельные окружения, проверить, что они не используют боевые базы и ключи.
- День 8-9: завести отдельные учетные записи и роли: для сервисов, для администраторов, для разработчиков (минимальные права).
- День 10-14: зафиксировать стандарт создания нового сервиса и прогнать пробный релиз по новой схеме.
Минимальные правила доступа
Prod должен быть доступен только тем, кому это нужно для поддержки. Например: разработчики ходят в dev/test, в prod - только дежурные админы; сервисы общаются между собой по белому списку; доступы выдаются по ролям, а не «всем по логину».
Чтобы это не зависело от памяти людей, закрепите короткий стандарт на одной странице: нейминг окружений, обязательные переменные, кто создает сервисные аккаунты, как проверяется доступ. Если инфраструктура размещается на своих серверах, заранее решите, где будут стоять узлы dev/test/prod и как они физически и логически отделены (например, на разных сегментах сети или даже в разных стойках).
Данные для тестирования: безопасно и без боли
Самый частый провал - когда в test просто копируют базу prod «как есть». Так вы переносите в тест реальные телефоны, ИИН, адреса, платежи и пароли. Дальше достаточно одного лишнего доступа или выгрузки дампа в общий чат, и у вас уже инцидент, а не тестирование.
Безопаснее считать, что тестовый контур - менее защищенная зона. Там больше людей, больше экспериментов, больше временных прав. Поэтому данные для теста должны быть полезными, но не «живыми».
Простой подход к обезличиванию
Не нужно строить идеальную систему с нуля. Начните с правил, которые дают большую часть эффекта:
- Маскируйте персональные поля (имя, телефон, email, ИИН): сохраняйте формат, но меняйте значения.
- Удаляйте лишнее: сканы документов, вложения, заметки операторов, логи, старые события.
- Заменяйте чувствительные справочники: номера карт, токены, ключи, пароли, ответы на секретные вопросы.
- «Сдвигайте» даты и суммы, если важна динамика (например, плюс 30 дней ко всем датам), но без привязки к реальности.
- Генерируйте небольшой набор «эталонных» кейсов (5-20 клиентов/заказов), чтобы проверять крайние сценарии.
Если нужен ориентир: маленькая клиника тестирует запись к врачу. В test достаточно 200 обезличенных пациентов и 2-3 месяцев расписаний, а не всей истории за годы.
Доступы, дампы и быстрое восстановление test
У каждой среды должны быть свои учетные записи БД и свои права. Даже если сервер один, разделяйте роли: dev не должен иметь доступ к prod-данным, а приложение из test не должно уметь писать в prod.
Дампы храните как секрет: ограниченный доступ, учет выдачи, понятные сроки хранения. Лучше, если дампы лежат отдельно от рабочих папок команды и не попадают в общие резервные копии «всего подряд».
Чтобы test быстро оживал после экспериментов, держите простой план отката: свежий обезличенный дамп, короткая инструкция восстановления и скрипт начальной настройки. Тогда тестовый стенд можно поднять за час, а не «чинить» два дня.
Доступы и секреты: минимальные правила, которые спасают
Большинство инцидентов в SMB начинаются не с хакеров, а с бытовых привычек: пароль в конфиге, токен в чате, ключ в README, случайный коммит в репозиторий. Исправлять это проще, чем кажется, если договориться о нескольких правилах и соблюдать их всегда.
Главное правило для разделения dev/test/prod: разные секреты для каждого контура. Даже при минимальной инфраструктуре ключи от базы, токены к внешним сервисам и доступы к платформе не должны совпадать. Тогда утечка из dev не превращается в доступ к prod.
Минимальное хранение секретов без сложных внедрений
Не обязательно сразу покупать дорогие системы. Важно, чтобы секреты не жили в коде и не пересылались в мессенджерах.
Обычно на старте хватает такого набора:
- хранить секреты как переменные окружения на сервере или в CI (с доступом по ролям);
- держать отдельные файлы конфигурации для dev/test/prod, но без секретов внутри;
- использовать один защищенный канал для передачи секретов (например, менеджер паролей) и правило «не скидывать в чат»;
- менять секреты при увольнении, смене подрядчика или подозрении на утечку;
- делать короткую проверку перед релизом: нет ли секретов в коммитах и логах.
Раздельные права: кто что может
Секреты часто «утекают» через лишние права. Если один аккаунт умеет и смотреть логи, и деплоить, и читать продовую базу, то любая ошибка становится дорогой.
Минимальная модель ролей:
- просмотр логов и метрик (без доступа к секретам и деплою);
- деплой в dev/test (без доступа к prod);
- деплой в prod (1-2 человека, по согласованию);
- доступ к БД: отдельные учетные записи на чтение и на запись.
Аудит изменений можно начать вручную: фиксируйте в коротком журнале, кто менял секрет, когда, зачем, где лежит новый и кто подтвердил. Пример: разработчик обновил токен платежного провайдера в test, записал задачу в трекере, а тимлид подтвердил, что в prod токен не трогали. Это дисциплина, которая предотвращает тихие поломки и «случайные» утечки.
Деплой без тормозов: простая схема CI/CD для SMB
Цель CI/CD в SMB простая: команда быстро выкатывает изменения в test, ловит ошибки раньше и выпускает в prod без суеты. Если у вас уже есть dev/test/prod, следующий шаг - сделать выкладки одинаковыми и предсказуемыми.
Начните с автоматизации того, что повторяется чаще всего и отнимает больше всего времени: сборка и выкладка в test. Это дает быстрый эффект даже без сложных инструментов.
Минимальный пайплайн, который работает
Процесс должен быть коротким и понятным. Один коммит приводит к одному и тому же результату, независимо от того, кто нажал кнопку.
- Коммит в основную ветку запускает сборку и прогон базовых тестов.
- Собранный артефакт (контейнер или архив) получает версию и сохраняется в реестре или хранилище.
- Авто-выкладка в test с теми же шагами, что и в prod.
- Автопроверки в test: health-check, короткие smoke-тесты, проверка логов на критичные ошибки.
- Ручное подтверждение перед prod (approve) и затем выкладка.
Ворота перед prod не должны быть формальностью. Обычно хватает двух условий: есть результат проверок в test и есть человек, который берет ответственность за выпуск (дежурный или тимлид).
Версии и конфиги: один язык для всей команды
Простое правило: код и конфиги версионируются одинаково. Для релизов используйте семантические версии (например, 1.8.3) и фиксируйте их тегом в репозитории, а конфиги держите отдельными значениями для окружений (dev/test/prod) через переменные среды или файлы параметров. Тогда любой релиз можно повторить, а не собирать заново «на глаз».
Если инфраструктура on-prem, пайплайн удобно держать на выделенном сервере, а выкладку в тестовый контур делать без доступа к продакшену.
План отката должен быть проверяемым. Считайте откат успешным, если сервис снова отвечает, ключевой сценарий проходит, а время укладывается в заранее оговоренный лимит (например, 10-15 минут).
- Храните минимум 2-3 предыдущих артефакта.
- Откат делайте той же командой, что и релиз (только с другой версией).
- Для базы данных используйте только «безопасные» миграции или готовьте обратные шаги.
- После отката прогоняйте тот же smoke-набор.
- Записывайте причину и точку восстановления, чтобы не повторить ошибку.
Типичные ошибки при разделении контуров
Частая проблема не в том, что контуры «неправильно названы», а в том, что они ведут себя как один и тот же prod. Тогда тесты становятся опасными, а команда перестает доверять dev и test.
Интеграции, которые забыли изолировать
Если тестовый стенд ходит в боевые сервисы, он рано или поздно сделает что-то «по-настоящему». Классический пример: test отправляет письма или SMS реальным клиентам, создает заказы в платежке или дергает CRM.
Правило простое: у каждого контура свои точки интеграций. Для внешних сервисов держите отдельные аккаунты или песочницы, а если их нет - ставьте заглушки и явные защитные флажки (например, запрет отправки сообщений наружу в test).
Секреты и доступы «одни и те же везде»
Одинаковые пароли, токены и ключи в dev/test/prod превращают любую ошибку в инцидент. Разработчик может случайно подключиться к продовой базе, а утечка из теста автоматически становится утечкой из прода.
Минимум, который реально работает:
- разные секреты для каждого контура и регулярная замена ключей;
- доступ в prod только по необходимости и с отдельными учетками;
- запрет «копировать prod.env в test, чтобы быстрее завелось».
«Быстрая проверка» прямо на проде
Тестирование на проде под видом «проверю маленькую правку» ломает дисциплину. Это начинается с одного запроса в базу, а заканчивается ручными правками данных и неожиданными побочными эффектами. Если нужно проверить именно продовые условия, используйте безопасные механизмы: feature flags, canary или хотя бы отдельного тестового пользователя и ограниченный сценарий.
Нет лимитов ресурсов
Когда dev/test живут рядом с prod без ограничений, тестовая нагрузка может съесть CPU, память или диски и уронить боевые сервисы. Часто это случается на ночных прогонах, импортах или нагрузочных тестах.
Поставьте простые границы: квоты, лимиты, отдельные очереди, а для тяжелых прогонов - отдельное окно времени.
Бэкап есть, но восстановление не проверяли
Бэкапы «на всякий случай» не спасают, если никто не пробовал восстановиться. Проверьте это заранее на test: поднимите базу из бэкапа, убедитесь, что приложение запускается, и измерьте реальное время восстановления. Тогда первый инцидент не станет экспериментом.
Короткий чеклист: готово ли разделение контуров
Проверьте не «как задумано», а «как работает по умолчанию». Часто проблемы начинаются там, где один удобный доступ со временем становится постоянной дырой.
Быстрые проверки (должно быть «да»)
- Из dev и test нет прямого доступа к prod по сети и по учеткам. Исключения есть только для строго нужного и они записаны (например, чтение метрик).
- Для каждого контура отдельные секреты и отдельные учетные записи. Пароли и ключи не совпадают, даже если «так проще».
- Тестовые данные отделены от боевых: либо есть отдельный набор, либо понятный способ обновлять его (и в процессе нет персональных данных без необходимости).
- Деплой в prod не делается «втихую»: нужно подтверждение (хотя бы approve), и факт релиза фиксируется (кто, когда, что именно).
- Откат понятен по времени и уже проверен на практике. Не «когда-нибудь сделаем», а реально делали и знаете, что займет, например, 10-30 минут.
С бэкапами не экономьте: регулярные копии prod должны делаться автоматически, а восстановление нужно хотя бы иногда прогонять. Бэкап, который никто не пробовал восстановить, часто оказывается просто файлом на диске.
Красные флаги (если есть хотя бы один - тормозите релизы)
- В dev лежат продовые ключи «временно», и это длится неделями.
- Разработчик может зайти в prod «на пару минут» без заявки и следа в логах.
- Откат зависит от одного человека, который «знает как», но нигде не записал.
Если по чеклисту все ок, команда выпускает чаще и спокойнее: ошибки ловятся в test, доступы не расползаются, а prod остается предсказуемым.
Пример: как SMB тестирует изменения и не ломает prod
Представим компанию на 50 человек: один сайт для клиентов и одна внутренняя система для продаж. Команда разработки - 3 человека, плюс один админ на полставки. Релизы выходят раз в неделю, и раньше все проверяли прямо на prod, потому что отдельного стенда не было.
Минимальный набор у них выглядит так: один сервер для виртуализации и еще один небольшой сервер (или тот же сервер, но с жесткими лимитами) под prod. На виртуализации крутятся три ВМ: dev (для ежедневной работы), test (для приемки), prod (только для пользователей). Важный момент: база данных prod отдельная и не шарится с dev/test, даже если все стоит рядом.
Проверка релиза устроена просто и повторяемо:
- разработчик выкладывает сборку в test;
- бизнес-пользователь проходит короткую приемку по сценарию (5-10 шагов);
- если все ок, тот же пакет ставят в prod в заранее выбранное окно;
- если нет, правка идет обратно в dev, а test остается чистым.
Чтобы снизить риск, в test используют не копию боевых данных, а обезличенный набор: имена заменены, телефоны и ИИН замаскированы, суммы округлены. И еще одно правило: интеграции разные. На test подключены песочницы или заглушки (например, тестовая оплата и тестовая почта), а на prod - реальные ключи и реальные адреса.
Через месяц появляется главный эффект от разделения dev/test/prod: релизы стали предсказуемыми. Раньше на каждую выкладку уходило 2-3 часа разборов и откатов. Теперь типовой релиз занимает 30-40 минут, а срочные правки почти исчезли, потому что большинство ошибок ловят на test до того, как их увидят пользователи.
Следующие шаги: как закрепить результат и масштабироваться
Когда базовое разделение dev/test/prod уже работает, главный риск не в технологии, а в том, что правила снова расплывутся. Закрепите границы письменно: какие сервисы относятся к dev, test и prod, какие интеграции и фоновые задачи обязаны быть разнесены, и что считается нарушением.
Полезно начать с короткой инвентаризации. Не только приложений, но и всего, что «за ними»:
- сервисы и базы данных, очереди, кэши, S3-подобные хранилища;
- интеграции: банк, гос-сервисы, почта, SMS, аналитика, 1С, BI;
- автоматические джобы: рассылки, биллинг, обмен данными, планировщики;
- точки входа: домены, VPN, админки, API для партнеров;
- данные и их источники: где берете тестовые и кто отвечает за очистку.
Дальше выберите правило роста: что усложняете первым, когда команда или нагрузка увеличатся. Обычно порядок такой: доступы и секреты (чтобы не было «общих паролей»), затем CI/CD (чтобы релизы были повторяемыми), затем наблюдаемость (логи, метрики, алерты), и только потом масштабирование железа.
Отдельно согласуйте роли и ритуалы, иначе скорость упадет. Кто имеет право деплоить в prod, кто подтверждает релиз, сколько людей нужно для решения, когда делаете откат, и где фиксируется причина. Простой подход: один ответственный за выпуск, один за проверку, откат по готовому сценарию без обсуждений.
Пример: небольшая финтех-команда вводит правило: каждое изменение сначала попадает в test с «похожими» интеграциями через песочницы и заглушки, и только после чеклиста выпускается в prod. Через месяц они добавляют отдельный мониторинг prod и сокращают время реакции на инциденты.
Если вы понимаете, что текущие ресурсы уже на пределе, заранее спланируйте, на каком железе будет жить test и prod без конкуренции за CPU и диск. Для надежного on-prem варианта в Казахстане это можно обсудить с GSE.kz (gse.kz): компания производит компьютеры и серверы в Казахстане, занимается системной интеграцией и обеспечивает круглосуточную техническую поддержку через сервисную сеть по стране.
Частые вопросы
Нам правда нужно делить dev, test и prod, если команда маленькая?
Да, если у вас есть реальные пользователи и регулярные изменения в системе. Минимальный смысл разделения — чтобы эксперименты и проверки не могли повлиять на работу бизнеса, а релиз в prod проходил по понятному и повторяемому пути.
С чего начать разделение, если сейчас все на одном сервере?
Сделайте отдельные учетные записи и разные секреты для каждого контура, разнесите базы данных и ограничьте сетевой доступ так, чтобы из dev/test нельзя было напрямую попасть в prod. Даже если все крутится на одном физическом сервере, изоляция по ВМ/сетям/правам уже снимает большую часть рисков.
Можно ли просто скопировать базу prod в test, чтобы «все было как в бою»?
По умолчанию — нет, потому что это переносит персональные и финансовые данные в менее защищенную среду. Лучше держать небольшой обезличенный срез или синтетические данные, которые можно быстро пересоздать, и отдельно настроить бэкапы и политики хранения для test.
Как обезличить данные для test быстро и без сложных проектов?
Делайте маскирование так, чтобы сохранялся формат, но не сохранялись реальные значения, и удаляйте лишнее вроде сканов, вложений и токенов. Если важна динамика, можно сдвигать даты и корректировать суммы так, чтобы тесты оставались полезными, но данные не привязывались к реальности.
Кто должен иметь доступ к prod и как это оформить без бюрократии?
Дайте право деплоя в prod одному-двум ответственным и уберите «общие логины». Разработчикам достаточно dev/test, а доступ к продовым логам и базе выдавайте только по необходимости и отдельными учетками, чтобы было понятно, кто и что делал.
Как организовать секреты, если у нас нет Vault и других сложных систем?
Держите разные секреты для dev/test/prod и не храните их в коде, README и чатах. На старте обычно достаточно переменных окружения на серверах или в CI с доступом по ролям и простого правила ротации ключей при увольнении, смене подрядчика или подозрении на утечку.
Какая самая простая схема CI/CD для dev/test/prod в SMB?
Автоматизируйте сборку и выкладку в test так, чтобы она повторяла шаги продакшена, а в prod оставьте ручное подтверждение. Важно, чтобы одна и та же версия артефакта доходила до prod, иначе вы тестируете одно, а выпускаете другое.
Что выбрать для минимальной инфраструктуры: ВМ или контейнеры?
Контейнеры удобны, когда приложение легко масштабируется без состояния, а база и файлы вынесены отдельно. Если у вас тяжелая БД, легаси-сервисы, требования к жесткой изоляции или часто конфликтуют версии ОС/зависимостей, отдельные ВМ обычно дают более предсказуемое поведение.
Можно ли оставить общий мониторинг и логи для всех контуров?
Разделите метки окружений и права доступа: общий сбор логов и мониторинг допустимы, если dev/test не получают лишнего доступа к продовым данным и секретам. Критично, чтобы продовые ключи, база и административные доступы оставались строго отдельными.
Как понять, что бэкапы и откаты действительно работают, а не «для галочки»?
Минимум — автоматические бэкапы prod и хотя бы периодическая проверка восстановления на test, чтобы знать реальное время подъема. Откат лучше считать готовым, когда он воспроизводится одной и той же процедурой и не зависит от «человека, который помнит как».
