8 мин
Миграция с VMware на Proxmox VE: план работ по этапам
Миграция с VMware на Proxmox VE без сюрпризов: инвентаризация, V2V, сеть и хранилище, бэкапы, окно переключения и план отката.
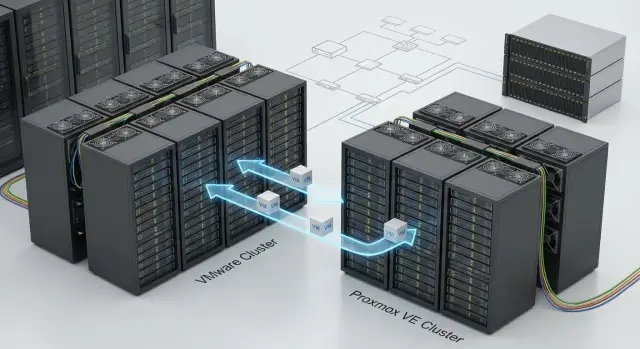
С чего начинается миграция и какие проблемы она решает
Переезд с VMware на Proxmox VE обычно начинается не с установки нового кластера, а с ответа на простой вопрос: какую проблему вы хотите убрать через 3-6 месяцев после переезда. Причины чаще всего практичные: рост стоимости владения, желание снизить зависимость от одного вендора, более понятная модель поддержки и возможность быстрее расширять инфраструктуру.
При этом миграция почти всегда про риски. Самые частые - незапланированные простои, сюрпризы с драйверами и гостевыми агентами после V2V-конвертации, а также ошибки на уровне сети и хранилища (VLAN, MTU, разные модели доступа к LUN или NFS). В документации это выглядит ровно, но «всплывает» при первом переносе боевой ВМ.
До технических работ стоит договориться с бизнесом о базовых вещах: какие сервисы критичны и в каком порядке их переключать, какой простой допустим (в минутах или часах), кто и по каким признакам принимает решение об откате, сколько времени нужно на наблюдение после переключения, и какие изменения запрещены в период миграции (заморозка релизов).
Ориентир простой: успех измеряется не фактом переноса, а тем, что пользователи почти ничего не заметили. Обычно критерии успеха включают доступность (сервис поднялся и работает стабильно), производительность (нет деградации по ключевым метрикам) и управляемость (резервные копии делаются, мониторинг видит ВМ, администраторы понимают, где смотреть логи).
Пример: если у вас есть бухгалтерия, файловый сервер и несколько внутренних веб-сервисов, логичнее сначала перенести менее критичный веб-сервис и проверить сеть, бэкапы и восстановление. И только потом планировать окно переключения для бухгалтерии.
Если вы делаете проект вместе с интегратором, заранее полезно зафиксировать границы ответственности: кто отвечает за железо, сеть и поддержку 24/7, а кто - за перенос и проверку сервисов. В GSE.kz, например, часто сразу разделяют эти зоны так, чтобы у заказчика не было «серых» участков, где непонятно, кто должен действовать.
Границы проекта и критерии успеха
Чтобы переезд не превратился в бесконечный проект, сначала фиксируют границы: что переносим, а что оставляем как есть. Обычно выбирают один из вариантов: перенос всего кластера целиком, перенос отдельных ESXi-хостов по очереди или перенос только части виртуальных машин (например, непроизводственных), чтобы обкатать подход.
Отдельно решите, переносите ли вы сопутствующие сущности: шаблоны ВМ, ISO-библиотеки, теги и папки, правила размещения, политики резервного копирования, расписания задач. Часть настроек VMware не имеет прямых аналогов, и их лучше описать заново понятными правилами. Например: какие ВМ должны жить на быстрых дисках, какие можно держать на емкостных, какие обязательно иметь в HA.
Дальше обозначают, какие сервисы реально затрагиваются. Если в периметре есть AD, базы данных, файловые серверы, VDI или критичные интеграции с внешними системами, им нужен отдельный план тестов и окно работ. Для VDI важнее всего задержки и сеть, для базы данных - консистентность дисков и понятная процедура остановки и запуска.
Ограничения тоже лучше записать явно: лицензии гостевых ОС и приложений, требования ИБ (сегментация, журналы, контроль доступа), локализация данных и запреты на вынос резервных копий за пределы площадки.
Критерии приемки удобно оформить как набор проверок «до» и «после» переключения:
- ВМ запускаются и видят свои диски и сеть. Имена и IP не меняются без согласования.
- Ключевые сервисы проходят функциональный тест (вход пользователей, доступ к файлам, запросы к БД).
- Производительность не хуже согласованного порога (CPU/RAM/диск, время отклика).
- Резервное копирование выполняется, и есть тестовое восстановление хотя бы одной ВМ.
- Есть документированный план отката и подтвержденное окно простоя.
Эти критерии стоит подписать заранее - так вы избегаете споров уровня «вроде работает» после переключения.
Инвентаризация: что нужно собрать до первого шага
Проекты миграции чаще ломаются не на конвертации, а на забытых деталях: «чья это ВМ», «какой у нее IP», «почему ночью запускается обмен», «куда уходит трафик». Поэтому сначала делайте инвентаризацию и фиксируйте ее как единый документ, понятный и ИТ, и владельцам сервисов.
Начните со списка виртуальных машин. Для каждой запишите ОС и назначение (например, 1С, файловый сервер, контроллер домена), критичность для бизнеса, владельца и контакты для согласования окна работ. Отдельно отметьте системы, где простой даже на 15 минут неприемлем, и те, что можно остановить на час.
Дальше нужны цифры: выделенные ресурсы (vCPU, RAM, размер и тип дисков) и реальная нагрузка в обычный день и в пик. Если есть данные по дисковой активности (IOPS, задержки), сохраните их, чтобы потом сравнить и не перепутать проблему переезда с «так было всегда».
Не менее важно собрать зависимости. У многих ВМ есть «невидимые ниточки»: связи между серверами приложений и БД, интеграции с внешними системами, расписания задач, ночные выгрузки и резервные копии. Здесь же отметьте особенности, которые могут помешать переносу: шифрование дисков, аппаратные ключи, очень старые ОС, специфичные драйверы или привязка лицензии к виртуальному железу.
Чтобы ничего не потерять, для каждой ВМ полезно пройти один и тот же небольшой чек:
- кто владелец сервиса и кто подтверждает переключение
- какие ресурсы и какая типовая загрузка
- какие другие системы нужны для работы и когда они «общаются»
- какие есть особые требования (шифрование, ключи, legacy)
- как устроена сеть: VLAN, IP, шлюз, важные правила маршрутизации
Простой пример: у поликлиники есть ВМ с регистратурой и отдельная ВМ с БД. Если не зафиксировать, что ночью идет обмен с внешней системой и что трафик ходит через конкретный VLAN, миграция пройдет «успешно», а утром записи пациентов не откроются.
Целевая архитектура Proxmox VE: кластер, сеть, хранилище
Целевая архитектура задает правила для всего переезда: как вы обеспечиваете доступность, где лежат диски ВМ, и что произойдет, если один узел или канал связи выйдет из строя. Ошибка на этом шаге обычно приводит не к «неудобству», а к простоям и сложному откату.
Кластер: один узел или HA
Если это лаборатория или небольшая площадка без требований к отказоустойчивости, один узел может быть разумным стартом. Для критичных сервисов чаще выбирают кластер минимум из трех узлов, чтобы нормально переживать отказ одного хоста и сохранять кворум.
Перед выбором модели ответьте на вопросы: какие ВМ должны подниматься автоматически, сколько минут простоя приемлемо, и есть ли отдельная площадка или контур для резервного копирования.
Сеть и хранилище: разделяйте роли
В Proxmox VE важно заранее разделить трафик по назначению: управление, трафик ВМ, миграции, доступ к хранилищу. На практике это делают отдельными VLAN или физическими интерфейсами, чтобы миграция или бэкапы не «душили» бизнес-сервисы.
По хранилищу выбор обычно такой: локальные диски (быстро и просто), ZFS (удобно для контроля целостности и снимков), внешнее SAN (если уже есть) или Ceph (для распределенного хранилища в кластере). Часто встречается гибрид: ОС и часть ВМ на ZFS, а большие тома на SAN.
Ориентиры, которые помогают не запутаться:
- Для HA без лишних сложностей обычно выбирают 3+ узла и понятную схему кворума.
- ZFS хорош, когда важны предсказуемость и контроль; Ceph имеет смысл, если вы готовы к более сложной эксплуатации.
- По сети минимум нужны отдельная сеть управления и отдельный путь для storage или миграции.
- По доступам работает принцип «минимально нужные права», плюс включенный аудит действий.
- По железу важны запас по CPU/RAM и быстрые диски, а для кластерных сценариев часто нужна 10/25G сеть.
Пример: у организации 30-40 ВМ, из них 10 критичных. Типовой выбор - кластер из трех серверов (например, на базе локально произведенных платформ уровня GSE S200), ZFS на каждом узле для быстрых дисков и отдельные сети для управления и миграции. Это дает понятную схему эксплуатации и снижает риск сюрпризов в день переключения.
Подготовка площадки: установка и базовая настройка
Перед тем как переносить первую ВМ, площадку лучше привести в предсказуемое состояние. Большая часть проблем появляется не из-за конвертации дисков, а из-за мелочей: разные версии firmware, неправильные режимы BIOS, «плавающее» время или DNS.
Начните с серверов. Обновите BIOS/UEFI, контроллеры хранения и сетевые адаптеры до согласованных версий. Заранее решите, как вы отдаете диски гипервизору: через RAID-контроллер (если важна простота) или через HBA/pass-through (если планируется программное хранилище). Проверьте ключевые настройки BIOS/UEFI: включена виртуализация CPU (VT-x/AMD-V) и IOMMU (если нужно), выставлен корректный порядок загрузки, отключены лишние энергосберегающие режимы, которые режут производительность.
После установки Proxmox VE задайте базовые параметры узла: корректное имя хоста, IP, шлюз, DNS, часовой пояс и NTP. Время должно быть одинаковым на всех узлах, иначе появляются странные ошибки в кластере, сертификатах и логах.
Дальше определите политику репозиториев и обновлений. Важно договориться, как часто вы обновляете узлы, кто это делает и как откатываете изменения, если апдейт повлиял на работу. Лучше сразу привести все узлы к одной версии и зафиксировать окно для регулярных обновлений.
Когда узлы готовы, соберите кластер и продумайте именование, теги и пулы ресурсов. Простое правило: по имени должно быть понятно, где узел стоит и для чего он (например, площадка, стойка, роль).
Перед переносом первой ВМ сделайте короткую проверку: видны ли все сети (VLAN/bridge), монтируются ли хранилища, хватает ли места, создается ли тестовая ВМ и стартует ли она. Это занимает около 15 минут, но экономит часы в день миграции.
P2V/V2V по шагам: перенос и первичная проверка ВМ
Перенос виртуальных машин почти всегда упирается в два вопроса: каким способом переносить и как быстро поймать скрытые проблемы после старта. Обычно выбирают один из трех путей: V2V-конвертацию, экспорт-импорт образов (OVF/диски) или восстановление из резервной копии, если бэкап поддерживает нужный формат.
Перед переносом каждую ВМ стоит подготовить, иначе вы перенесете в новую среду старые ошибки. Удалите ненужные снапшоты и убедитесь, что они сконсолидированы, проверьте файловую систему в гостевой ОС, освободите место на диске (особенно на системном), выключите ВМ штатно.
Практичный порядок работ обычно такой:
- Выберите метод переноса для конкретной ВМ.
- Сконвертируйте диски и определитесь с форматом: qcow2 удобен из-за снапшотов, raw часто выбирают ради максимальной скорости.
- Подберите контроллер диска и сетевой адаптер. VirtIO обычно дает лучшую производительность, но может потребовать драйверы в гостевой ОС.
- После первого запуска удалите или замените VMware Tools, установите qemu-guest-agent и нужные драйверы.
- Проведите короткий тест: сеть (IP, DNS), ключевые службы, вход пользователей, базовая нагрузка и просмотр логов.
Пример: Windows-сервер после переноса загрузился, но сеть «падает» через минуту. Частая причина - старый vmxnet-драйвер или конфликт с VMware Tools. Решение обычно простое: удалить VMware Tools, поставить VirtIO-драйвер и перезагрузить.
Фиксируйте результат для каждой ВМ: что поменяли (драйвер, контроллер, порядок загрузки), сколько заняло времени, какие действия повторить в боевом окне. Так разовый удачный перенос превращается в предсказуемый сценарий.
Сеть и хранилище: настройка и типовые подводные камни
При переезде больше всего сюрпризов обычно дают сеть и хранилище. ВМ может успешно сконвертироваться, но не выйти в сеть или начать «тормозить» из-за другой модели дисков и кэшей.
С сетью начните с сопоставления логики: какие VLAN были в vSwitch и порт-группах, какие физические интерфейсы их обслуживают, и какие bridge вы заведете на узлах Proxmox. Отдельно проверьте MTU: если где-то включены jumbo frames (например, для хранилища), то несовпадение MTU на одном участке приводит к потерям пакетов и долгим таймаутам.
Чтобы тестировать ВМ параллельно со старой средой, заранее продумайте IP и DNS. Типовой сценарий: вы переносите ВМ, поднимаете ее в тестовой VLAN, но DNS уже указывает на боевой IP. В итоге пользователи попадают не туда, а в журналах начинается путаница.
Практика, которая снижает риск:
- Для тестов выделите отдельную VLAN или временный диапазон IP.
- Фиксируйте, где меняете MAC/IP, чтобы не поймать конфликт.
- Планируйте переключение DNS с учетом TTL и кэшей.
- Если есть DHCP, проверьте резервации и привязки.
- Документируйте, какие порты на коммутаторах должны быть trunk и какие VLAN разрешены.
Фаерволы: в Proxmox правила могут жить на уровне датацентра, ноды и ВМ. Переносите их не «как получится», а как набор правил с понятным владельцем и местом применения. Хорошая привычка: сначала включить минимально необходимое (доступ для админки и сервисов), а затем добавлять ограничения по мере проверки.
По хранилищу важно заранее решить политику thin/thick, квоты и особенности вроде дедупликации (если она используется на уровне СХД). Одинаковый объем диска в гостевой ОС может дать разную реальную нагрузку на пул, особенно при thin.
Перед боевым переключением сделайте простые тесты производительности и связности: замерьте скорость чтения/записи внутри ВМ, проверьте задержку до СХД (если она внешняя) и прогоните копирование большого файла между ВМ в разных VLAN. Если уже на тестах есть нестабильность, в окно переключения она легко станет аварией.
Резервное копирование и восстановление перед переключением
До начала миграции договоритесь о понятных целях по данным и времени простоя. Для разных групп ВМ требования разные: бухгалтерия может терпеть простой дольше, а, например, система записи пациентов или платежный шлюз - почти нет. Зафиксируйте RPO (сколько данных можно потерять) и RTO (как быстро нужно поднять сервис) и разделите ВМ на критичные и некритичные.
Дальше нужен контрольный полный бэкап перед любыми конвертациями. Важно не только сделать копию, но и один раз реально восстановить ее в тест: иначе о проблеме вы узнаете в самый плохой момент. Проверка должна включать запуск ОС, доступность приложения и целостность данных.
Чтобы бэкапы не «съели» миграцию, заранее спланируйте нагрузку. Во время массовых копирований часто упираются в сеть и диски, из-за чего растут окна работ и падает скорость V2V-конвертации. Выберите время, ограничьте параллельность и следите за IOPS и пропускной способностью.
Что стоит закрепить письменно:
- RPO/RTO по группам ВМ и порядок приоритета.
- Полный бэкап с контрольной датой и результатом тестового восстановления.
- Где хранятся копии: отдельное хранилище, изоляция, права доступа.
- Расписание на период миграции и лимиты по нагрузке.
- План возврата к бэкапам, если откат по плану переключения не сработал.
Простой пример: для критичной ВМ с базой данных вы делаете полный бэкап на отдельное хранилище, проверяете восстановление на тестовом узле, а в ночь переключения добавляете финальный инкремент и фиксируете точку, к которой можно вернуться при любой ошибке.
Пример сценария миграции: волнами, без резкого отключения
Представим компанию на 50-200 пользователей: 25-40 виртуальных машин, две площадки (основная и резервная). Цель - перейти на Proxmox VE без большого простоя и без сюрпризов в понедельник утром. Подход «волнами» хорошо работает, потому что вы проверяете все по частям, а не одним рискованным прыжком.
Обычно ВМ делят на волны по уровню риска и зависимостям: сначала то, что можно быстро поднять и легко откатить, затем постепенно приближаться к самым критичным сервисам. На практике часто получается так: тестовая волна (стенды, вспомогательные сервисы, 1-2 ВМ для проверки V2V и сети), пилот (несколько рабочих ВМ небольшого отдела), затем основные сервисы (файлы, 1С/ERP, базы данных, терминальные сервисы), и уже после - периферийные системы (мониторинг, печать, второстепенные веб-сервисы, архивы).
Чтобы запуск был параллельным и не влиял на прод, чаще всего делают так: переносят ВМ, поднимают их в изолированной сети или с временными IP, проверяют вход в систему, доступ к дискам и работу приложений. Для сервисов с данными накапливают дельту (репликация, повторная синхронизация, финальный импорт) и только в окне переключения меняют маршрутизацию, DNS или VIP.
Пример расписания: вечером в пятницу перенос волны и первичная проверка, ночью - переключение пользователей и сервисов по заранее утвержденному порядку, утром - быстрые проверки с бизнесом и фиксация результатов.
Важно заранее договориться, что именно вы измеряете и записываете до и после:
- время загрузки ВМ и время старта ключевых служб
- отклик приложений (вход, открытие формы, типовая операция)
- ошибки в логах и обращения пользователей по категориям
- нагрузку CPU, RAM, диска и сети в пике
- фактический простой по каждому сервису
Если вы работаете с интегратором, удобно поручить ему фиксацию метрик и единый журнал изменений, чтобы каждая волна заканчивалась понятным статусом: готово, нужен допуск, или откат.
Окно переключения и откат: четкий порядок действий
Окно переключения - это короткий период, когда вы меняете источник работы сервисов: было на VMware, становится на Proxmox VE. Для многих именно здесь решается, будет ли миграция спокойной или превратится в ночной аврал. Идея простая: заранее договориться, что делаем, кто делает и по каким признакам принимаем решение откатываться.
Перед началом окна подготовьте организационный минимум: заморозьте изменения (релизы, правки фаерволов, расширения дисков), разошлите уведомления с ожиданиями по недоступности, назначьте роли (сеть, приложения, коммуникация с бизнесом), соберите контакты и доступы, подготовьте контрольные проверки «что считать успехом» для каждого сервиса.
Порядок переключения почти всегда похож. Сначала поднимают инфраструктурные сервисы (DNS, DHCP, AD/LDAP, мониторинг, резервное копирование), затем ключевые приложения (база данных, очереди, файловые сервисы), и только потом второстепенные ВМ. Если бухгалтерия зависит от SQL и домена, сначала проверяете доменную авторизацию и доступ к базе, и лишь затем включаете прикладную ВМ.
План отката должен быть таким же конкретным, как и план переключения. Заранее решите, что считается стоп-сигналом, и кто говорит финальное «откатываемся». Частые триггеры:
- критичная функция недоступна дольше согласованного времени (например, 30-60 минут)
- обнаружена потеря или рассинхронизация данных
- не проходят базовые проверки сети (маршрутизация, NAT, доступ к хранилищу)
- производительность упала до уровня, который мешает работе
- нет прогресса по устранению ошибки в течение фиксированного времени
Технически откат чаще всего сводится к возврату запуска ВМ на VMware, обратному переключению DNS (и, при необходимости, заранее уменьшают TTL), возврату маршрутов и NAT на прежние значения. Важно: откат - это не «разобраться потом», а заранее прописанный набор шагов.
После переключения проведите пост-проверки: доступность сервисов с рабочих мест, целостность данных (особенно у баз), журналы ошибок, загрузку CPU/RAM/дисков, алерты мониторинга. Если нет своей дежурной команды, на окно полезно привлекать интегратора с 24/7 поддержкой и понятным SLA, чтобы решение об откате принималось быстро и по фактам.
Частые ошибки и как их избежать
Самые болезненные сбои при миграции случаются не из-за конвертации дисков, а из-за мелочей, которые «и так должны работать». Чаще всего это сеть, бэкапы и порядок действий.
Первая ловушка - недооценка сети. Если в старой среде были VLAN, jumbo frames и отдельные интерфейсы под хранилище, в новой это должно быть воспроизведено осознанно. Неправильный MTU часто выглядит как «то работает, то нет»: ВМ пингуется, но база данных рвется под нагрузкой.
Вторая ошибка - перенос без проверки восстановления. Наличие бэкапа не равно возможности поднять сервис. Минимум один раз восстановите тестовую ВМ в изолированной сети и проверьте вход, данные и запуск служб.
Третья - слишком большой первый шаг. Когда переносят все критичные ВМ сразу, любая неизвестная проблема превращается в простой бизнеса. Лучше начать с одной-двух систем средней важности, отточить процесс и только потом идти в ядро.
Четвертая - изменения в последний момент: патчи, правки DNS, новые правила на фаерволе, «давайте еще один сервер добавим». Это ломает план и усложняет поиск причин.
Чтобы снизить риск, заранее закрепите владельцев сервисов (кто принимает результат и кто дает доступы), критерии приемки (что значит «работает»: метрики, пользователи, отчеты), запрет на внеплановые изменения в период переключения, отдельную проверку сети (VLAN, MTU, маршрутизация, доступ к storage) и тест восстановления бэкапа до окна переключения.
Отдельный частый провал - игнорирование лицензий и требований регуляторов к данным и логам. В госсекторе и финансах это критично: сроки хранения, место размещения, доступ к журналам. Проверьте это до миграции, а не после, когда сервис уже переехал.
Короткие чеклисты и следующие шаги после миграции
После основного переноса больше всего проблем появляется из-за «мелочей»: забыли свежий бэкап, не согласовали окно, не проверили VLAN, не подготовили доступы. Ниже - чеклисты, которые помогают не упустить критичное.
Мини-чеклист перед стартом
- Инвентарь: список ВМ, их роли, зависимости (AD, DNS, БД), критичность и допустимый простой.
- Резервные копии: когда сделаны, где лежат, есть тест восстановления на отдельной ВМ.
- Тестовый перенос: одна некритичная ВМ прошла V2V и запускается без ошибок.
- Схема сети: VLAN, шлюзы, DNS, правила фаервола, кто за что отвечает.
- Хранилище: где будут диски ВМ, хватает ли места и IOPS под пиковые нагрузки.
Мини-чеклист перед окном переключения
За 24-48 часов до окна зафиксируйте порядок действий и роли:
- Заморозка изменений: запрет на обновления и изменения конфигураций в VMware.
- Уведомления: бизнес, служба поддержки, владельцы систем, время начала и окончания.
- План отката: что считается провалом, сколько времени ждем, как возвращаемся назад.
- Доступы: консоли, учетные записи, пароли, доступ к сетевому оборудованию и хранилищу.
- Контрольная точка: финальный бэкап/снимок и подтверждение, что он читается.
После переключения первые 2-4 часа держите усиленный мониторинг: загрузка CPU/RAM, задержки диска, сетевые ошибки, логи Proxmox и гостевых ОС. Полезно заранее подготовить короткий список «симптом - действие», например что делать при проблемах со временем, драйверами сети или производительностью диска.
Дальше стоит привести хозяйство в порядок: стандартизировать шаблоны ВМ (драйверы, агенты, параметры дисков), настроить регулярные обновления и окна обслуживания, описать финальную схему сети и хранилища, зафиксировать правила бэкапов и RPO/RTO.
Если вам нужна помощь не только с миграцией, но и с подбором серверов, внедрением и дальнейшей эксплуатацией, удобно, когда это закрывается в одном контуре ответственности. GSE.kz (gse.kz) работает как производитель серверов и системный интегратор, а также оказывает круглосуточную техническую поддержку, что часто упрощает поддержку инфраструктуры после переезда.
Частые вопросы
С чего правильно начинать миграцию с VMware на Proxmox VE?
Начинайте с формулировки проблемы, которую вы хотите убрать после переезда: стоимость владения, зависимость от вендора, сложная поддержка, медленное масштабирование. Затем зафиксируйте, как вы поймете, что проблема действительно решена: доступность, производительность и управляемость (бэкапы, мониторинг, понятные логи). Это сразу задает приоритеты и защищает от миграции «ради миграции».
Какие решения нужно согласовать с бизнесом до технических работ?
Минимальный набор — допустимый простой по каждому сервису, порядок переключения, ответственные, критерии приемки и условия отката. Отдельно договоритесь о «заморозке изменений» на время окна, чтобы релизы, правки DNS или фаерволов не смешались с миграцией. Чем точнее эти договоренности, тем меньше ночных сюрпризов.
Какие риски при переезде встречаются чаще всего и почему?
Чаще всего проблемы дают неожиданные простои, драйверы и агенты после V2V, а также сеть и хранилище: VLAN, MTU, маршрутизация, доступ к LUN/NFS и модель кэшей. Еще одна частая причина — забытые зависимости между ВМ и задачами по расписанию, которые проявляются только ночью или в пик. Лучшее лечение — ранний тестовый перенос и фиксация результатов как повторяемого сценария.
Что именно нужно собрать в инвентаризации перед первым переносом?
Соберите единый список ВМ с владельцами, назначением, критичностью и допустимым простоем, чтобы было кому подтвердить переключение. Добавьте параметры ресурсов и реальные метрики нагрузки, чтобы после переезда отличать «стало хуже» от «так было всегда». Обязательно зафиксируйте зависимости: базы данных, AD/DNS, внешние интеграции, ночные обмены, лицензии и любые привязки к виртуальному железу.
Как выбрать первую ВМ для тестовой миграции?
Обычно начинают с наименее критичных систем, чтобы проверить сеть, бэкапы, восстановление и типовые драйверные проблемы. Такой пилот быстро показывает, где «тонко»: MTU, VLAN, контроллеры дисков, VirtIO-драйверы, политика обновлений. После пилота перенос ключевых сервисов становится плановым, а не экспериментом.
Сколько узлов нужно для кластера Proxmox VE и когда достаточно одного?
Для отказоустойчивости в Proxmox VE чаще выбирают кластер минимум из трех узлов, чтобы сохранялся кворум при отказе одного хоста. Один узел уместен для лаборатории или некритичных сервисов, где простой допустим и нет требований к автоматическому поднятию ВМ. Решение лучше принимать от требований по времени простоя и сценариев отказа, а не от количества текущих ВМ.
Как правильно спланировать сеть, чтобы переезд не сломал доступ к сервисам?
Самый практичный подход — разделить трафик по ролям: управление, трафик ВМ, миграции и доступ к хранилищу, чтобы конвертации и бэкапы не влияли на пользователей. Проверьте соответствие VLAN и MTU на всем пути, иначе получите «плавающие» обрывы под нагрузкой. Для тестов лучше поднимать перенесенные ВМ в изолированной сети или с временными IP, чтобы не устроить конфликт DNS и адресов.
Каким способом переносить ВМ и что важно учесть при V2V?
Чаще всего выбирают V2V-конвертацию, экспорт/импорт образов или восстановление из резервной копии, если ваш бэкап это поддерживает. По дискам qcow2 удобен для снапшотов, raw часто берут ради скорости; контроллер и сетевой адаптер обычно переводят на VirtIO, но драйверы в гостевой ОС нужно подготовить. После первого старта обычно удаляют VMware Tools и ставят qemu-guest-agent, а затем проверяют сеть, службы и логи.
Что обязательно сделать с резервными копиями до окна переключения?
Сделайте контрольный полный бэкап до любых конвертаций и один раз реально восстановите его в тестовой среде, чтобы убедиться, что сервис поднимается и данные целые. Зафиксируйте RPO и RTO по группам ВМ, чтобы понимать, где нужна финальная синхронизация перед переключением. На время миграции ограничьте параллельность бэкапов и конвертаций, иначе упретесь в сеть и диски и сорвете окно работ.
Как подготовить план отката и не потерять время в ночь миграции?
У отката должны быть понятные триггеры и один ответственный за решение, иначе время будет уходить на споры. Технически откат обычно сводится к возврату запуска ВМ на VMware и обратному переключению DNS/маршрутов/NAT, поэтому эти шаги нужно заранее отрепетировать и подготовить доступы. Если проект делается с интегратором, заранее разделите зоны ответственности за железо, сеть, перенос и поддержку 24/7, чтобы не было «серых» участков; у GSE.kz такой раздел часто фиксируют до начала работ.
