7 мин
Минимальная архитектура Kubernetes on-prem без подписок
Разбираем минимальная архитектура Kubernetes on-prem: CNI, Ingress, registry, мониторинг, а также требования к серверам и сети для стабильной работы.
Задача: поднять Kubernetes on-prem без платных подписок
Kubernetes on-prem выбирают, когда важны контроль над данными, предсказуемость поставок и независимость от облака. Но Kubernetes решает только часть задач: запускает контейнеры и поддерживает их работу. Если не собрать вокруг него базовую архитектуру, быстро появляются «ручные» обходные пути: странные сетевые сбои, отсутствие нормальной публикации сервисов наружу, хаос с образами и слепые зоны в мониторинге.
Платные подписки чаще всего дают не «магию», а набор готовых ответов на типовые вопросы. Обычно это проверенная сеть (CNI), балансировка для сервисов, Ingress и TLS, приватный registry, мониторинг и алерты, политики безопасности, обновления и поддержка. Почти все это можно закрыть бесплатными компонентами, если заранее принять, что интеграция и эксплуатационные правила - ваша зона ответственности.
Для первого релиза важно не распыляться. Достаточно базового набора, который делает кластер пригодным для ежедневной работы: CNI, Ingress и внешний IP, приватный registry, мониторинг с метриками и алертами.
Границы простые: без сложного мультикластера, без service mesh, без «платформы как продукт». Цель - поднять минимальный, устойчивый фундамент, на который потом спокойно наращиваются безопасность, логирование и процессы обновлений.
Минимальный стек: что должно быть в кластере
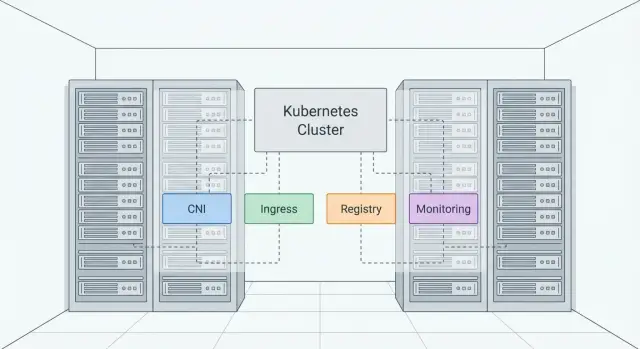
Минимальная архитектура Kubernetes on-prem - это не «поставить Kubernetes», а собрать небольшой набор обязательных деталей, без которых кластер быстро становится хрупким.
База всегда состоит из control plane и worker-узлов. Для устойчивости control plane лучше планировать не «один сервер на все», а хотя бы 3 узла control plane (или 1 на старте, но с понятным планом расширения). Worker-узлы на старте обычно делают 2-3, чтобы переживать отказ одного.
Дальше идут компоненты, без которых эксплуатация почти всегда превращается в импровизацию:
- CNI - сеть подов и сетевые политики.
- Ingress - публикация сервисов и управление TLS.
- Registry - хранение образов и контроль версий.
- Мониторинг - понимание, что происходит с узлами, подами и control plane.
То, что часто пытаются добавить сразу, но обычно можно отложить до появления реальной потребности: service mesh, GitOps-платформа, распределенная СХД, сложный IAM и тонкая многоарендность. На старте они чаще добавляют новые точки отказа, чем пользу.
Где on-prem чаще всего теряет устойчивость: сеть (MTU, маршрутизация, «флапающие» порты), DNS (внутренние резолвы и кэш), storage (непонятные классы томов и нехватка IOPS), обновления (когда нет тестового контура и процедуры отката). Минимальный стек стоит выбирать так, чтобы каждую часть можно было обновлять и диагностировать отдельно.
Хороший ориентир: если компонент нельзя быстро объяснить дежурному инженеру и нельзя одной командой проверить, что он жив, значит сейчас он лишний.
Требования к серверам: базовые ориентиры для кластера
Главный риск on-prem - не «мало железа», а то, что один сбой выключает половину платформы. Поэтому минимальный вариант для устойчивости - 3 узла control plane (etcd и компоненты управления) и 2-3 worker-узла под приложения. Один control plane допустим только для стенда.
По CPU и RAM проще всего считать от реальности: сколько сервисов запускается одновременно и где пик нагрузки (например, отчеты в конце месяца). Как стартовая точка для небольшого продакшена:
- Control plane: 4-8 vCPU и 16-32 ГБ RAM на узел.
- Worker: 8-16 vCPU и 32-64 ГБ RAM на узел.
- Запас: держите 20-30% свободных ресурсов, чтобы кластер переживал перезапуски и плановые работы.
Диск часто становится узким местом, особенно когда появляются метрики и логи. Желательно разделять хотя бы логически (а лучше физически) роли дисков: ОС отдельно, контейнерные данные (containerd/Docker) отдельно, и отдельный быстрый том под данные мониторинга. Если используете локальное хранилище для stateful-нагрузок, требования к дискам резко растут: NVMe и понятная стратегия бэкапов становятся обязательными.
RAID важен, потому что «в облаке заменили диск» тут нет. Для системных дисков обычно хватает RAID1, для данных и метрик - RAID10 (или аналог по надежности и скорости). Отдельно проверьте, как вы переживете выход из строя диска на узле с важными данными.
Перед установкой проверьте питание и охлаждение: два блока питания в серверах, UPS хотя бы на корректное завершение работы, нормальная вентиляция стойки. Для организаций в Казахстане иногда критично, чтобы оборудование и поддержка были доступны локально, без долгих пауз в поставках и ремонте.
Требования к сети: DNS, NTP, MTU и план IP
Сеть в on-prem Kubernetes часто ломается не из-за «сложного Kubernetes», а из-за мелочей: разные MTU на участках, слабый DNS или плавающие часы. Если привести базовые параметры к одному стандарту, архитектура начинает вести себя предсказуемо.
Для балансировки и публикации сервисов заранее решите, какой у вас уровень сети. MetalLB в L2-режиме проще всего, но обычно требует, чтобы ноды и клиенты были в одном L2-сегменте (один VLAN, без маршрутизации между ними). Если сеть L3 и сегментирована, чаще выбирают BGP-режим MetalLB, где маршруты до VIP объявляются через роутеры. Это сложнее на старте, зато лучше ложится на корпоративные сети.
MTU стоит проверить до установки CNI. Если где-то по пути MTU 1500, а CNI добавляет оверхед (например, VXLAN), пакеты начинают фрагментироваться или тихо теряться. Симптомы типичные: часть сервисов «иногда» не открывается, readiness-проверки падают, а дебаг ничего не показывает. Практичное правило: один MTU для всех линков и заранее выбранный подход - оверлей или без него.
DNS и NTP - два сервиса, без которых кластер ведет себя странно. DNS нужен не только подам, но и компонентам кластера (CoreDNS ходит в upstream). NTP важен для TLS: сертификаты, токены и аудит зависят от времени.
Перед запуском зафиксируйте:
- Pod CIDR и Service CIDR, чтобы не пересекались с корпоративными диапазонами и VPN.
- Диапазон адресов LoadBalancer (если используете MetalLB).
- Кто и откуда имеет доступ к Kubernetes API (6443) и к Ingress (обычно 80/443).
- Сегментацию: админские сети отдельно, приложения отдельно, доступы только по нужным портам.
Хороший быстрый тест: разверните пробный namespace и проверьте, что из офисной сети открывается Ingress, а к API доступ есть только с админских хостов. Ошибки маршрутизации и правил доступа проявляются сразу.
CNI: как выбрать и настроить без лишней сложности
CNI отвечает за то, как поды видят друг друга по сети: маршрутизацию, раздачу IP, работу Service, а также сетевые политики (NetworkPolicy). В on-prem именно CNI часто становится источником «странных» обрывов и долгих расследований, поэтому лучше выбирать простое и предсказуемое решение.
Если вам нужна только связность подов и сервисов без сегментации, часто хватает Flannel. Он легкий и понятный, но почти не помогает с NetworkPolicy. Если нужен контроль доступа между неймспейсами и сервисами, чаще выбирают Calico: он зрелый, хорошо закрывает сетевые политики и обычно без сюрпризов на стандартных ядрах Linux. Cilium стоит рассматривать, если важны расширенная наблюдаемость и более гибкие политики, но он требовательнее к ядру и аккуратности при обновлениях.
Что включить из NetworkPolicy в первом релизе
Не пытайтесь сразу «закрыть все». Начните с минимального набора правил и проверяйте, что сервисы не ломаются:
- Запрет трафика по умолчанию в «прод» namespace и явные разрешения на нужные порты.
- Разрешение DNS (обычно kube-dns/CoreDNS) для всех подов.
- Разрешение входа только от Ingress-контроллера к веб-сервисам.
- Разрешение доступа к базам данных только от конкретных приложений.
Совместимость и быстрые тесты
Перед установкой проверьте требования CNI к ядру и режимам (нужны ли модули, eBPF, iptables/nftables). Лучше зафиксировать это в стандарте образа ОС для всех узлов.
До запуска «боевых» сервисов прогоните простые проверки: pod-под (внутри и между нодами), доступ к DNS, работа Service/NodePort, применение NetworkPolicy. Практичный сценарий: развернуть два тестовых приложения (frontend и backend) и убедиться, что политика действительно блокирует лишнее.
Ingress на on-prem: публикация сервисов и TLS
Ingress нужен почти всем, даже в закрытой сети. Он дает единый вход в кластер по HTTP(S): один адрес и набор правил вместо десятков NodePort, а также понятный контроль маршрутизации. Это удобно для внутренних порталов, API, мониторинга и любых сервисов, где важны домены и TLS.
Для старта чаще всего выбирают Ingress Controller на базе NGINX. Он закрывает 80-90% задач без экзотики: хосты, пути, редиректы, лимиты, простая аутентификация. Альтернативы (Traefik, HAProxy Ingress) тоже рабочие, но NGINX обычно проще для команды, которая не хочет тратить неделю на тонкую настройку.
TLS лучше сразу делать «как в проде», иначе потом будет больно мигрировать.
TLS: хранение и обновление сертификатов
Сертификаты обычно лежат в Kubernetes Secrets, а приложения получают их через Ingress. Чтобы не обновлять руками каждую неделю, заведите единый процесс: определите источник сертификатов (внутренний УЦ или публичный), настройте автоматическое обновление (например, через cert-manager), храните приватные ключи только в нужных namespace и заранее проверьте политики доступа.
Как дать Ingress внешний IP в on-prem
На bare metal нужен способ получить стабильный IP для входа. Обычно выбирают одно из решений: MetalLB, существующий аппаратный L4 или балансировщик от провайдера площадки (если он есть в контуре).
Полезная практика: разделить внешний и внутренний трафик разными IngressClass. Например, internal для сервисов сотрудников и external для ограниченного набора публичных endpoints. В небольшой организации в Казахстане это часто означает внутренний доступ для офисных систем, а внешний - только для пары сервисов через DMZ.
Registry: где хранить образы и как жить в закрытом контуре
Без собственного registry кластер быстро упирается в две вещи: скорость и контроль. Публичные реестры могут быть недоступны, медленны или внезапно ограничить доступ. Плюс теряется единый источник правды: какие образы разрешены, кто их загрузил и когда.
Для минимальной архитектуры обычно хватает одного внутреннего реестра, к которому имеют доступ все ноды и CI. Практичный вариант для старта - Harbor: проекты, роли, базовая интеграция с LDAP/AD, политики хранения и удобный интерфейс. Если нужно совсем просто, подойдет и стандартный Docker Registry с basic auth, но тогда права, уборку и зеркалирование придется собирать вручную.
Хранилище образов проще всего начать с локального диска на отдельной VM или на выделенном сервере: меньше зависимостей, быстрее запуск. Когда объем растет или нужен отказоустойчивый storage, смотрите в сторону S3-совместимого хранилища (on-prem). Это удобнее для масштабирования, но добавляет еще один сервис в поддержку.
Сканирование уязвимостей и подписи образов полезны, но не обязательны в первый день. Часто достаточно базовой гигиены: фиксировать теги, хранить SBOM где возможно и иметь понятный процесс обновлений. Подписи (например, cosign) логично включать, когда появляется регулярный выпуск и требования безопасности.
Если интернета нет или он нестабилен, заранее готовят набор зависимостей: образы Kubernetes-аддонов, базовые образы приложений, Helm charts. Удобно держать «зеркальные» проекты в Harbor и обновлять их по расписанию из изолированной зоны.
Перед запуском зафиксируйте хотя бы четыре решения: где живет registry, какой storage используется, кто имеет права push/pull, и как вы чистите старые теги, чтобы не закончился диск.
Мониторинг и логи: минимально достаточный набор
Без мониторинга и логов on-prem кластер быстро превращается в лотерею. Базовый набор можно поднять без подписок и без лишней нагрузки.
Минимум, который закрывает большинство проблем: Prometheus для метрик, Alertmanager для уведомлений, Grafana для дашбордов. Этого достаточно, чтобы видеть деградации и получать сигнал до того, как пользователи заметят сбой.
В первую очередь следите не за всем подряд, а за тем, что ломается чаще всего: состояние нод и kubelet, заполнение дисков и задержки, здоровье etcd и API, DNS и потери пакетов, ошибки 4xx/5xx и время ответа на Ingress.
С логами лучше стартовать просто. Для небольшого кластера часто хватает Loki (логи из pods плюс поиск в Grafana). Если нужна «классика» и сложные фильтры, можно взять EFK, но он заметно тяжелее по ресурсам.
Алерты делайте короткими и полезными, иначе их начнут игнорировать. Обычно спасают ночью несколько сигналов: диск почти заполнен, etcd недоступен или растет задержка, API возвращает много 5xx, узел стал NotReady, Ingress резко увеличил 5xx.
Про хранение метрик договоритесь сразу. Для старта часто хватает ретеншна 7-15 дней, чтобы разбирать инциденты и видеть тренды. Диск под метрики обычно заканчивается неожиданно, поэтому лучше заранее задать лимит и проверить расход места при вашей частоте скрейпа и количестве подов.
Пошаговый план: поднять базовый стек за несколько итераций
Чтобы минимальная архитектура Kubernetes on-prem не превратилась в набор разрозненных установок, двигайтесь короткими итерациями и фиксируйте результат после каждой. Главное правило: один выбранный способ установки и максимальная повторяемость (одни и те же версии, одинаковые настройки на всех узлах).
Начните с подготовки. Сведите в одну таблицу сервера (CPU, RAM, диски), роли (control plane и workers), IP-адреса и доступы. Проверьте базу сети: DNS резолвит имена, NTP синхронизирует время, MTU одинаковый между узлами.
Дальше удобно идти так:
- Итерация 1: устанавливаете Kubernetes (часто kubeadm) и проверяете, что узлы в состоянии Ready, а перезагрузка узла не ломает кластер.
- Итерация 2: подключаете CNI и проверяете связность: pod с одной ноды ходит в pod на другой, сервис доступен по ClusterIP.
- Итерация 3: поднимаете Ingress и проверяете тестовый сервис с TLS: запрос снаружи доходит до приложения, сертификат корректный.
- Итерация 4: разворачиваете registry (например, Harbor), настраиваете pull secret и проверяете, что namespace тянет образ без доступа в интернет.
- Итерация 5: ставите мониторинг (Prometheus и Grafana) и проверяете алерты на искусственной проблеме, например временно заполняете диск на тестовом узле.
В конце каждой итерации делайте короткий контроль: что изменили, где лежат манифесты, как откатиться. Это экономит часы, когда установку нужно повторить на новых серверах.
Частые ошибки и ловушки в on-prem Kubernetes
Самая частая ошибка - собрать все на одном узле и ждать устойчивости. Для теста это терпимо, но в работе любая перезагрузка превращается в простой: control plane и workloads падают вместе.
Вторая ловушка - не продумать резервирование control plane и etcd. Если etcd живет на одном сервере или на тех же дисках, что и рабочие нагрузки, кластер становится трудно восстановить даже после мелкой аварии.
Сеть тоже часто ломает запуск. Диапазоны Pod/Service берут «на глаз», а потом они пересекаются с корпоративными подсетями, VPN или филиалами. Итог - странные таймауты и пропадающие маршруты при простой причине: конфликт адресов.
Еще одна типовая проблема - оставить Kubernetes API и админские панели доступными из широкой сети. Даже без внешнего интернета это риск: достаточно одной скомпрометированной машины в офисном сегменте.
И наконец, многие не ставят лимиты на рост данных. Логи, метрики и временные файлы быстро забивают диск, после чего начинаются падения kubelet и неожиданные рестарты.
Набор проверок, который чаще всего спасает:
- Разнести роли: минимум 3 control plane и отдельные worker, если нужна устойчивость.
- Зафиксировать Pod/Service CIDR и проверить, что они не пересекаются с корпоративными сетями.
- Закрыть доступ к API: отдельная подсеть, firewall, минимум прав для пользователей.
- Настроить ретеншн и квоты для логов и метрик, следить за заполнением дисков.
- Обновляться только с тестовым контуром и понятным планом отката.
Быстрый чеклист перед запуском в работу
Перед тем как отдавать кластер командам и включать боевые нагрузки, полезно сделать короткую проверку. Она занимает час-два и часто экономит ночи.
Проверьте базовые опоры:
- Control plane не в одиночку: минимум 3 узла control plane, а worker вынесены отдельно.
- DNS и NTP стабильны: имена резолвятся одинаково со всех нод, время синхронизировано.
- Сеть без сюрпризов: MTU одинаковый, нет потерь пакетов и странной фрагментации.
- Есть резервные копии критичного: регулярный backup etcd, данных registry и конфигураций мониторинга.
- Алерты не «для галочки»: есть хотя бы несколько базовых сигналов и понятный канал уведомлений.
Отдельно договоритесь о простом плане обновлений и отката: обновляем по одному узлу, заранее фиксируем версии, проверяем ключевые сервисы, держим понятный шаг назад (снимок etcd, откат манифестов, возврат версии нод) без импровизации в момент сбоя.
Пример: небольшой устойчивый кластер для организации в Казахстане
Типичный сценарий для ведомства, клиники или учебного учреждения: 15-30 внутренних сервисов (порталы, интеграции, очереди, несколько баз, отчеты), доступ из локальной сети и иногда через VPN. Контур закрытый, обновления возможны раз в месяц или реже. Нередко есть требование по локальному происхождению оборудования и прозрачности поставок.
Минимально устойчивый вариант начинается не с количества сервисов, а с разведения ролей по узлам. Когда control plane, Ingress и мониторинг живут на одних и тех же машинах, любая нагрузка или сбой превращаются в каскад.
Понятная раскладка для небольшого on-prem кластера:
- 3 узла control plane (только управление кластером, без прикладных подов)
- 2 узла Ingress (выделенные, с фиксированными IP через MetalLB)
- 3-6 рабочих узлов под сервисы (с запасом по CPU и памяти)
- 1 узел под registry (Harbor) и артефакты, с отдельным диском/RAID
- 1 узел под мониторинг (Prometheus + Grafana), тоже с отдельным диском
В первый месяц стоит поставить то, что снижает риск простоя: CNI, Ingress, DNS/NTP, registry для закрытого контура, базовый мониторинг и алерты. На квартал вперед обычно переносят более тяжелые вещи: централизованные логи, HA для registry и мониторинга, регулярный процесс обновлений.
Понять, что кластер стал стабильнее, помогают простые метрики: число инцидентов за месяц, среднее время восстановления, доля успешных деплоев, перезапуски подов, заполнение дисков и время ответа API Kubernetes.
Следующие шаги: от плана к закупке и эксплуатации
Когда базовый стек понятен, его нужно превратить в короткий, проверяемый план. Зафиксируйте компоненты первой очереди: CNI, Ingress, балансировка (если нужна), registry, мониторинг, резервное копирование etcd и правила обновлений. Чем меньше «на потом», тем меньше сюрпризов в пилоте.
Дальше составьте спецификацию под ваш размер кластера. Удобнее идти от нагрузки к ресурсам, а не наоборот. Отдельно проговорите сеть: IP-план, VLAN/сегментацию, доступ к DNS/NTP, MTU и точки выхода в интернет или в закрытый контур.
Перед закупкой проверьте риски поставок и поддержки. В on-prem часто ломается не железо, а сроки: несовместимые сетевые карты, ожидание дисков, разные партии серверов. Лучше заранее закрепить одинаковые конфигурации узлов, список совместимых компонентов и понятный канал сервиса.
Минимальный набор решений до запуска в эксплуатацию:
- кто владелец кластера и кто делает обновления (Kubernetes и аддоны)
- как вы храните секреты и кто имеет доступ
- где лежат бэкапы (etcd, registry, конфигурации) и как часто вы проверяете восстановление
- какие метрики и алерты обязательны
- график техокон и правила внесения изменений
Если нужен локальный поставщик «под ключ» - от серверов до системной интеграции и поддержки, имеет смысл смотреть в сторону GSE.kz (gse.kz). Это казахстанский производитель и системный интегратор: в портфеле есть рабочие станции, ПК и серверы, а также услуги по построению инфраструктуры и 24/7 техподдержка через сервисную сеть.
Частые вопросы
Что нужно для минимального Kubernetes on-prem кластера?
Для первого рабочего контура достаточно Kubernetes, CNI, Ingress с TLS, стабильного внешнего IP, приватного registry и базового мониторинга. Этот набор закрывает сеть, публикацию сервисов, доставку образов и контроль состояния кластера.
Сколько серверов нужно для устойчивого кластера?
Для небольшого продакшена планируйте 3 control plane и 2-3 worker-узла. Один control plane годится для стенда, но его перезагрузка или отказ остановит управление кластером.
Какие CPU и RAM нужны Kubernetes-узлам?
В качестве старта дайте каждому control plane 4-8 vCPU и 16-32 ГБ RAM, а worker-узлу 8-16 vCPU и 32-64 ГБ RAM. Оставляйте 20-30% ресурсов свободными, чтобы пережить отказ узла и плановые работы.
Какой CNI выбрать: Flannel, Calico или Cilium?
Flannel подойдет, если нужна простая связность подов без сетевой сегментации. Calico лучше выбрать, когда требуются NetworkPolicy и контроль доступа между сервисами. Cilium имеет смысл брать при потребности в расширенной наблюдаемости и готовности внимательно проверять совместимость ядра и обновления.
Какие NetworkPolicy нужны в первом релизе?
Начните с запрета трафика по умолчанию в production namespace, затем явно разрешите DNS и нужные связи сервисов. Например, веб-приложение должно принимать трафик только от Ingress, а база данных - только от своего приложения.
Зачем нужен Ingress и как дать ему внешний IP?
Ingress дает сервисам единый HTTP(S)-вход, домены, маршрутизацию и TLS вместо множества NodePort. На bare metal ему нужен стабильный адрес: его обычно выдает MetalLB, аппаратный балансировщик или балансировщик площадки.
Какой registry поставить в закрытом контуре?
Harbor подходит для большинства закрытых контуров: он хранит образы, разделяет проекты и роли, умеет работать с LDAP или AD и помогает чистить старые теги. Для совсем простого стенда можно взять Docker Registry, но права и обслуживание придется организовать самостоятельно.
Что проверить в сети до установки Kubernetes?
Проверьте, что Pod CIDR и Service CIDR не пересекаются с корпоративными сетями и VPN. До установки CNI выровняйте MTU на маршруте между узлами, настройте надежные DNS и NTP, а доступ к API на порту 6443 ограничьте админской сетью.
Какой мониторинг нужен без платной подписки?
Поставьте Prometheus, Alertmanager и Grafana. В первую очередь следите за состоянием узлов, заполнением и задержками дисков, etcd, API, DNS, ошибками Ingress и временем ответа. Для метрик на старте обычно хватает хранения 7-15 дней.
Какие проверки выполнить перед запуском кластера в работу?
Сначала убедитесь, что узлы переживают перезагрузку, поды работают между разными нодами, DNS и Service доступны, а Ingress отдает тестовый сервис с корректным сертификатом. Затем проверьте загрузку образа из внутреннего registry и срабатывание хотя бы одного тестового алерта.
