8 мин
Git-платформы для enterprise: чек-лист по безопасности и SSO
Git-платформы для enterprise: сравним GitHub Enterprise, GitLab и Bitbucket по безопасности, зеркалам репозиториев, SSO и хранению артефактов.
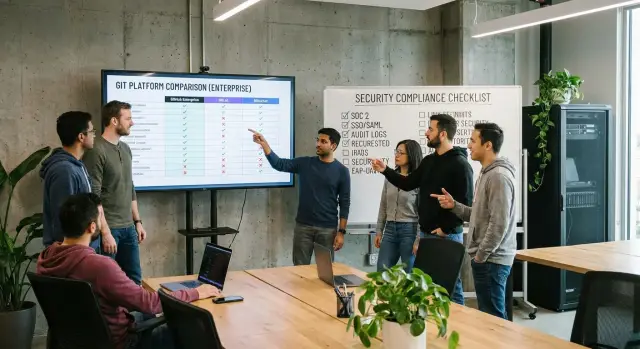
Какие проблемы решает enterprise Git-платформа
Когда команда вырастает с пары разработчиков до нескольких десятков, проблемы появляются не в Git как инструменте, а в процессах вокруг него. Становится сотни репозиториев, правила в разных проектах расходятся, а доступы перестают быть прозрачными. То, что работало на уровне "договоримся в чате", в большой организации быстро превращается в риск.
Ценность Git-платформы для enterprise обычно не в интерфейсе, а в контроле: кто и что может сделать, как это фиксируется, где хранятся данные и как вы восстановитесь после сбоя. Почти всегда в фокусе четыре темы: доступы и SSO, аудит действий, хранение кода и артефактов, резервирование и зеркала.
Облако удобно для старта, но в крупных организациях быстро упираются в ограничения: требования к размещению данных, проверяемость цепочки поставок, правила закупок и регуляторика. On-prem дает больше контроля, но добавляет ответственность за инфраструктуру, обновления, бэкапы и реагирование на инциденты.
Перед тем как выбирать GitHub Enterprise, GitLab или Bitbucket, ответьте на несколько прикладных вопросов. Как вы будете выдавать и отзывать доступы (SSO, группы, роли, временные права)? Какие события обязаны попадать в аудит (входы, изменения прав, пуши, удаления, настройки)? Что нужно хранить кроме кода (контейнеры, пакеты, сборки CI/CD) и каков срок хранения? Как устроены резервирование и восстановление (RPO/RTO, зеркала, регулярная проверка восстановления)? Какие есть ограничения по размещению данных и интеграциям, например для госсектора или финансов?
Пример: в организации со строгой ИБ (госструктура, банк, медучреждение) обычно сразу требуют централизованный аудит и предсказуемое хранение артефактов. Иначе при расследовании инцидента выяснится, что часть действий не логируется, а нужная сборка уже удалена политикой очистки.
GitHub Enterprise, GitLab, Bitbucket: когда что выбирать
Если сравнивать платформы без маркетинга, выбор обычно упирается в три вещи: экосистема (с чем вы уже живете), контроль (где и как хранятся код и артефакты) и цена владения (лицензии, администрирование, масштабирование).
GitHub Enterprise часто выбирают за удобство для разработчиков, сильный code review и развитую экосистему интеграций. Он хорошо подходит там, где важны практики open-source и inner-source, а политика доступа опирается на корпоративный каталог.
GitLab обычно берут, когда нужен подход "все в одном": репозитории плюс встроенный CI/CD, пакеты и реестр контейнеров, политики и инструменты безопасности. Это уменьшает число отдельных систем, но повышает требования к настройке и ресурсам инфраструктуры.
Bitbucket логично смотрится в компаниях, где Jira и Confluence уже стали стандартом. Там проще связывать задачи, ветки и релизы, а доступы часто легче вписать в существующие процессы.
Ограничения чаще всего всплывают не на демо, а после запуска: лицензирование по пользователям и "гостям", стоимость функций безопасности, пределы масштабирования (число проектов, размеры репозиториев, нагрузка от CI и зеркалирования).
Перед выбором заранее согласуйте с бизнесом и службой ИБ несколько вещей: где будет развертывание (облако, on-prem, гибрид) и какие данные нельзя выносить; как будет устроен SSO и жизненный цикл учетных записей (увольнение, подрядчики, MFA); нужна ли стратегия зеркал и требования к RPO/RTO; где и сколько хранить артефакты CI/CD, кто имеет доступ и как проверять целостность; какие отчеты по аудиту и событиям нужны для проверок и расследований.
Простой пример: если организация использует Atlassian как "систему правды" для задач и релизов, Bitbucket часто сокращает путь внедрения. Если же ИБ требует единый контроль кода, пайплайнов и артефактов в одном контуре, GitLab может оказаться понятнее, при условии что вы готовы инвестировать в администрирование и ресурсы.
Модель развертывания и требования к инфраструктуре
Модель развертывания напрямую влияет на безопасность, стоимость и скорость изменений. На практике обычно рассматривают три варианта:
- SaaS: быстрый старт, меньше забот об обновлениях, но меньше контроля над местом хранения данных и сетевыми ограничениями.
- Self-managed (on-prem или в вашем облаке): больше контроля над данными, интеграциями и политиками ИБ, но нужны ресурсы на поддержку.
- Гибрид: часть функций в SaaS, часть внутри периметра (например, исходники и секреты внутри, внешние интеграции снаружи).
Дальше стоит проверить сеть. Платформа почти всегда становится критической точкой, поэтому ей нужен отдельный сегмент, понятные правила доступа и минимизация "широких" разрешений. Частый сценарий: разработчики работают из офиса и через VPN, а CI-раннеры и сервисные аккаунты ходят к Git только по внутренним адресам. Если есть строгие требования по суверенитету данных (например, в госсекторе Казахстана), self-managed и сегментация обычно проще согласуются с ИБ.
Высокую доступность лучше планировать заранее, а не после первой аварии. Для этого нужны кластер или как минимум репликация, разделение ролей (приложение, база данных, хранилище) и понятное окно обновлений. Важно заранее договориться, кто и как ставит патчи: подход "редко, но больно" обычно заканчивается срочными простоями.
Резервные копии должны покрывать не только репозитории. Минимальный набор обычно включает:
- базу данных (пользователи, права, настройки, аудит)
- секреты и ключи (токены, интеграции, подписи)
- конфигурацию приложения и параметры SSO
- хранилище артефактов и контейнерный реестр (если используются)
- журналирование и аудит-логи (для расследований)
Проверьте, что бэкапы можно восстановить в отдельной среде, и что время восстановления соответствует вашим требованиям.
Базовый чек-лист безопасности для Git-платформы
Безопасность начинается не с галочек в настройках, а с правил: кто и зачем получает доступ, что считается критичным, как быстро вы заметите проблему. Эти правила лучше закрепить короткой политикой и сделать настройки обязательными по умолчанию.
Доступ и учетные записи
Проверьте RBAC и принцип минимальных прав. Права лучше выдавать не людям напрямую, а через группы и команды, привязанные к проектам. Хороший признак - разработчик видит только свои репозитории, а доступ на запись выдается по роли (например, Maintainer), а не "на всякий случай".
Базовый набор требований, который обычно закрывает большинство рисков:
- обязательная MFA для всех пользователей, особенно для администраторов
- политика паролей (если не весь вход через SSO): длина, сложность, срок, запрет повторов
- ограничения по IP (например, доступ к админке только из корпоративной сети)
- правила для устройств: запрет входа с неизвестных устройств или требование корпоративного агента, если это возможно
- отдельные админ-аккаунты без повседневной работы (без коммитов и CI)
Логи и работа с секретами
Логи должны отвечать на вопрос "кто, что и когда сделал" и быть защищены от удаления. Заранее зафиксируйте, какие события обязаны логироваться:
- входы, ошибки входа, отключение MFA
- изменения прав, ролей, групп, владельцев проектов
- создание и удаление токенов, ключей, секретов CI
- изменения настроек репозитория (ветки, защиты, webhooks)
- действия администраторов и операции с runner-ами CI
Секреты (токены, SSH-ключи, переменные CI) храните только в защищенных хранилищах платформы, с ротацией и сроком жизни. Включите сканирование утечек: проще поймать случайно закоммиченный ключ в тот же день, чем разбираться с инцидентом через месяц.
Пример: если команда выложила в репозиторий токен к тестовой базе, автоматическое правило должно сразу заблокировать токен и открыть задачу на замену доступа.
SSO и управление доступом: что проверить до запуска
В больших организациях SSO выбирают не ради удобства, а ради контроля. Он должен быть понятным, повторяемым и проверяемым, иначе права быстро "расползутся" по проектам.
Начните с протокола и источника истины. SAML обычно используют для браузерного входа и строгих корпоративных политик. OIDC часто удобнее для современных приложений и токенов. LDAP/AD нужен, если учетные записи и группы живут в Active Directory и вы хотите опираться на него.
Перед запуском проверьте:
- какие методы реально поддерживаются в вашей схеме (SAML, OIDC, LDAP/AD) и что будет обязательным методом входа
- есть ли SCIM (или аналог) для автоматического создания, блокировки и удаления пользователей
- как группы и атрибуты из IdP превращаются в права в Git (разработчик, мейнтейнер, админ, доступ к проектам)
- где настраиваются MFA и требования к паролям, и кто владелец политики
- как обрабатываются исключения: подрядчики, временный доступ, аварийные админы
Жизненный цикл пользователей важнее разовой настройки. Сценарий "увольнение сегодня" должен за минуты приводить к блокировке доступа, отзыву ключей и токенов, а также к фиксации события в аудите.
Отдельно разберите сервисные аккаунты и ботов. Им лучше выдавать минимальные права, хранить секреты в управляемом хранилище, включить ротацию токенов и запретить интерактивный вход через SSO.
Практичный пример: если у организации есть отдельные группы в IdP для разработки, эксплуатации и ИБ, заранее согласуйте таблицу соответствий "группа -> роль -> проекты". Это снижает ручную раздачу доступов и споры после инцидента.
Зеркала репозиториев и стратегия резервирования
Зеркала репозиториев нужны не только как "копия на всякий случай". В enterprise они закрывают четыре частых задачи: аварийное восстановление (DR), работа с географией (офисы и ЦОДы в разных регионах), быстрые миграции между платформами и разделение периметров (например, отдельный контур для разработки и отдельный для эксплуатации).
Одностороннее зеркалирование проще и безопаснее: есть один источник истины, а зеркало только читает и подтягивает изменения. Это хороший вариант для DR и для размещения копии ближе к командам. Двустороннее зеркалирование выглядит удобно, но часто приводит к спорным ситуациям: кто "главный", что делать при разъезде истории, как разруливать force-push и переписанные ветки.
Если бизнес все же требует двусторонний режим, заранее зафиксируйте правила: какие ветки можно переписывать, кто имеет право на push и как быстро вы отключаете одну сторону при инциденте.
Частота синхронизации зависит от критичности. Для ключевых репозиториев обычно ставят короткий интервал, но не в ущерб стабильности: чем чаще, тем выше нагрузка на API и сеть, и тем больше шансов поймать конфликт. Конфликты проще предотвращать процессом: запрет force-push в защищенных ветках, обязательные merge request/pull request, единые правила именования и короткий список "золотых" репозиториев, где требования строже.
Резервирование должно покрывать не только git-историю. Проверьте, что в бэкап попадают:
- сами репозитории (включая LFS, если он используется)
- wiki и вложения
- issues, PR/MR и комментарии
- настройки проектов, хуки, переменные CI/CD, секреты (с учетом политики хранения)
- данные пользователей, групп, прав, токенов и аудит-логи
Практический пример: организация с двумя площадками в Казахстане держит основной контур разработки в одном ЦОД, а во втором поддерживает зеркало только для чтения и ежедневные полные бэкапы метаданных. При отказе первой площадки команды сохраняют доступ к коду, а восстановление "управляющей части" (права, задачи, настройки) идет по заранее проверенному сценарию.
Хранение артефактов: правила, сроки и контроль целостности
Артефакты CI/CD - это не только "сборка приложения". Сюда обычно попадают пакеты (npm, Maven, NuGet), Docker-образы, установщики, результаты сборки, отчеты тестов и сканеров, а иногда и шаблоны инфраструктуры. В enterprise они быстро становятся таким же ценным активом, как исходники, поэтому правила хранения лучше зафиксировать заранее.
Минимальные правила хранения
Начните с набора политик, который понятен и разработчикам, и ИБ:
- что именно хранится в артефактах, а что запрещено (секреты, ключи, дампы с персональными данными)
- сроки хранения по типам: ночные сборки, релизные сборки, отчеты аудита, образы для продакшена
- квоты и очистка: кто отвечает за переполнение, как работает автоудаление, что считается "зафиксированным релизом"
- юридические требования: где физически лежат данные (регион, дата-центр), кто имеет доступ к выгрузкам и бэкапам
Если есть регулирование или требования к локализации, часто удобнее держать registry и хранилище артефактов внутри периметра, а доступ выдавать по роли и окружению.
Подпись, целостность и разделение окружений
Контроль целостности сводится к двум вещам: артефакт нельзя незаметно подменить, и всегда понятно, откуда он взялся. Практичный минимум - подпись (или проверяемые хэши) для релизных артефактов и запрет публикации "в обход пайплайна". Отдельно проверьте, что логи сборки и метаданные (commit, автор, pipeline, зависимости) сохраняются вместе с артефактом.
Разделяйте dev/test/prod не только по репозиториям, но и по хранилищам и правам публикации. Пример: разработчики могут публиковать в dev, релиз-менеджер - прод, а доступ на чтение в прод есть у эксплуатации и службы ИБ. Это снижает риск случайного выката и упрощает расследования.
Аудит, мониторинг и готовность к инцидентам
Даже аккуратно настроенные платформы чаще ломаются не из-за "дыр", а из-за того, что никто вовремя не заметил странную активность. Поэтому аудит и мониторинг стоит продумать до запуска: что пишем в логи, куда их отправляем, кто смотрит и что делает при тревоге.
Следы обычно размазаны по нескольким слоям: сама платформа (входы, права, операции с репозиториями), CI/CD (запуски пайплайнов, переменные, секреты), SSO/IdP (факторы, ошибки, блокировки) и сетевой периметр (WAF, VPN, прокси, firewall). Важно, чтобы время везде было синхронизировано, иначе расследование превратится в угадайку.
Для интеграции с SIEM заранее согласуйте, какие события и поля обязательны. Минимальный набор, который почти всегда нужен:
- аутентификация: success/fail, причина отказа, MFA/метод, исходный IP, user agent
- доступ и права: кто выдал/отозвал роль, какая роль, в каком проекте/группе
- токены и ключи: создание, использование, ротация, истечение, scope
- репозитории: клонирование, push/force-push, удаление веток/тегов, изменение protected-правил
- CI/CD: запуск пайплайна, кто запустил, какие окружения/раннеры, доступ к секретам
Алерты лучше делать простыми и редкими: подозрительные логины (новая география, всплеск неудачных попыток), массовые изменения прав, внезапное появление админов, резкий рост выдачи токенов, неожиданный force-push в защищенную ветку.
Регламент реагирования должен отвечать на четыре вопроса: кто дежурит, как эскалируем, что можно блокировать без согласования, как фиксируем доказательства.
- 1-я линия: подтверждает инцидент, собирает контекст из SIEM и логов
- владелец платформы: временно ограничивает доступы, отключает токены/раннеры
- ИБ: определяет масштаб, сохраняет артефакты, решает про уведомления
- команда разработки: проверяет изменения в коде и пайплайнах
- пост-инцидент: разбор причин и конкретные правки (правила, роли, ротация секретов)
Пример: в организации со строгой ИБ (гос или финансы) тревога "массовая выдача прав maintainer" должна автоматически поднимать инцидент. Это быстрый путь к подмене кода и сборке вредоносного артефакта.
Пошаговый план выбора и пилота (без лишней теории)
Начните не со сравнения фич, а с короткого набора требований. Важнее всего договориться между ИБ, разработкой, комплаенсом и закупками: что обязательно, а что можно отложить на второй этап.
Рабочий порядок, который обычно помогает избежать бесконечных обсуждений:
- Соберите требования в одном документе: SSO (SAML/OIDC), роли и права, требования к хранению данных, журналирование, сроки хранения артефактов, ограничения по внешним интеграциям.
- Выберите 2-3 реальных сценария для пилота: типовой репозиторий, CI/CD пайплайн, подключение SSO, выпуск и хранение артефактов (пакеты, контейнеры, сборки).
- Прогоните пилот на тестовой группе (например, 1 команда и 1 сервис), но с настоящими политиками доступа и реальными секретами, как в проде.
- Проверьте миграцию: перенос истории, веток, тегов, PR/MR, правил защиты веток, а также соответствие прав после переноса.
- Зафиксируйте результаты: что работает, где есть риски, сколько стоит владение (инфраструктура, лицензии, администрирование, поддержка).
После пилота принимайте решение по матрице критериев. Удобно оценивать по 5-балльной шкале и заранее задать веса (например, ИБ важнее удобства UI).
Критерии, которые чаще всего решают исход:
- выполнимость требований ИБ и комплаенса (аудит, логи, контроль доступа)
- интеграция с SSO и жизненным циклом учетных записей
- надежность бэкапов и зеркал, понятное восстановление
- политики артефактов: сроки, неизменяемость, контроль целостности
Пример: если организация из госсектора в Казахстане требует локального размещения, строгий аудит и 24/7 поддержку, пилот должен сразу включать эти условия, а не "потом настроим".
Частые ошибки при внедрении Git-платформы в enterprise
В больших организациях внедрение Git часто ломается не на выборе GitHub Enterprise, GitLab или Bitbucket, а на мелких решениях, которые никто не закрепил. В итоге растут риски по ИБ, расходы и время на сопровождение.
Ошибки, которые всплывают через 1-2 месяца после запуска
Часто начинают с локальных аккаунтов, а потом "как-нибудь" подключают SSO. Если при этом не настроить SCIM (или другой механизм автоматической выдачи и отзыва доступов), пользователи остаются активными после увольнения или смены роли.
Вторая боль - артефакты CI/CD. Если не договориться, что хранится, где и сколько, репозиторий пакетов и кеши сборок быстро съедают место. Потом появляется срочная "чистка", и внезапно невозможно воспроизвести релиз.
Третья ошибка - зеркалирование и бэкапы ради галочки. Делают зеркало репозиториев, но не проводят тест восстановления, не назначают ответственных и не фиксируют RPO/RTO. В день инцидента выясняется, что "копия есть", а восстановить не получается.
Четвертая - смешанные права. Когда разработчикам дают админские полномочия "чтобы было быстрее", отключаются важные проверки: защита веток, обязательные ревью, запрет force push. Пятая - аудит включили, но не смотрят: логи есть, реакции нет.
Как снизить риск без лишней бюрократии
- Включите SSO с принудительным входом и настройте автоматическое управление учетками (SCIM), плюс периодический пересмотр групп.
- Утвердите политику артефактов: сроки хранения, кто владелец, что является "золотой" копией релиза.
- Регулярно проводите тест восстановления из бэкапа и с зеркала, с понятным чек-листом и дежурными.
- Разведите роли: отдельные админы платформы, отдельные владельцы проектов, минимальные привилегии.
Если внедрение идет через интегратора и у организации свой дата-центр (часто так бывает в госсекторе и финсфере), эти договоренности лучше закрепить до пилота, иначе исправления будут болезненными.
Короткий чек-лист перед запуском и что делать дальше
Перед тем как открывать доступ командам, полезно пройти финальный контроль. Он помогает поймать типовые проблемы: доступы настроены, но никто не понимает, кто за что отвечает; бэкапы есть, но восстановление не проверяли; артефакты копятся без срока хранения.
Проверьте:
- SSO включено, а MFA обязательно для всех учетных записей (особенно админов и владельцев проектов). Описан жизненный цикл пользователя: создание, изменение прав, блокировка, увольнение, доступ подрядчиков.
- Права доступа понятны и проверяемы: роли и группы настроены, у каждого проекта есть владелец, а для критичных действий действует правило двух человек (например, изменение настроек защиты веток или отключение проверок).
- Резервирование работает не на бумаге: есть расписание бэкапов, ответственные, хранение копий в отдельной зоне и проведен тест восстановления с фиксацией времени.
- Зеркала репозиториев включены там, где нужно: для устойчивости, требований регулятора или геораспределенных команд.
- Артефакты CI/CD под контролем: сроки хранения, доступы, автоматическая очистка, проверка целостности (хеши/подписи) для релизных сборок.
После запуска не пытайтесь сразу включить все для всех. Сначала закрепите процесс: проведите пилот на 1-2 командах и измерьте время выдачи доступа, частоту инцидентов и скорость восстановления; дайте короткое обучение по токенам, секретам, защищенным веткам и код-ревью; утвердите регламенты (кто администрирует, как заводятся проекты, как оформляются исключения); настройте поддержку и дежурства. Если внутри нет 24/7, заранее определите внешнюю линию эскалации. Запланируйте пересмотр настроек через 30-60 дней по результатам пилота.
Пример сценария: выбор платформы для организации со строгой ИБ
Представим банк или госорганизацию: несколько команд разработки, часть подрядчиков, строгие требования по доступу и хранению данных. Код нельзя выносить в публичное облако, а проверки ИБ требуют прозрачного аудита действий и понятной схемы резервирования.
Ключевые требования обычно выглядят так: развертывание on-prem, единый вход через SSO (например, AD/LDAP/SAML), обязательный аудит (кто и что делал в репозитории и CI), зеркала репозиториев для отказоустойчивости, а также хранение артефактов и логов сборок годами. Сюда же добавляют правила по секретам (запрет токенов в коде), обязательные ревью и контроль прав на уровне групп.
Практичный подход - начать с пилота на 1-2 критичных проектах, а не переносить сразу все.
Во время пилота стоит проверить:
- как работает SSO и аварийный доступ (break-glass) при сбое IdP
- полноту аудита и удобство выгрузок для службы ИБ
- сценарий отказа: реплика, зеркало, восстановление из бэкапа, RTO/RPO
- хранение артефактов: сроки, неизменяемость, контроль целостности
- интеграции с CI/CD и запреты по политикам (merge, approvals, protected branches)
После пилота делайте миграцию волнами: сначала команды с похожими процессами, затем более сложные, параллельно обновляя регламенты (права, ревью, ротация ключей, срок жизни артефактов).
Интегратор полезен там, где чаще всего возникают риски: подобрать и развернуть инфраструктуру, настроить зеркалирование и бэкапы, описать процедуры восстановления и реагирования. Для on-prem сценария обычно важно, чтобы железо и поддержка были в том же контуре: например, серверы S200 Series от GSE.kz и их 24/7 техническая поддержка могут закрыть часть требований к надежности и сопровождению платформы.
Частые вопросы
Как понять, что нам уже нужна enterprise Git-платформа, а не просто Git?
Вам нужна enterprise Git-платформа, когда начинаются проблемы с управлением доступами, едиными правилами по проектам и воспроизводимостью изменений. Типичные триггеры — много команд и репозиториев, требования ИБ к аудиту, необходимость централизованно хранить артефакты и быстро восстанавливаться после сбоев.
Какие настройки безопасности стоит включить в первую очередь после запуска?
Обычно базовый минимум — обязательная MFA, роли и права через группы, защищенные ветки, обязательное ревью и запрет опасных действий вроде force-push в критичные ветки. Сверху добавьте понятный процесс выдачи временных доступов для подрядчиков и отдельные админ-аккаунты без повседневной работы.
Что самое важное проверить в SSO перед пилотом?
SSO выбирают ради контроля, поэтому главное — чтобы жизненный цикл учетной записи был автоматизирован. Проверьте, что увольнение или смена роли приводит к быстрому отключению доступа, отзыву токенов и фиксации события в аудите, а не требует ручных действий админов.
Какие события должны обязательно попадать в аудит Git-платформы?
Минимально — события аутентификации, изменения прав и ролей, операции с токенами и ключами, изменения настроек репозитория и действия администраторов. Логи должны быть защищены от удаления и синхронизированы по времени с IdP и CI/CD, иначе расследования будут неточными.
Как практично выбрать между GitHub Enterprise, GitLab и Bitbucket?
GitHub Enterprise чаще выбирают за удобный code review и сильную экосистему интеграций, GitLab — когда нужен подход «все в одном» с CI/CD и реестрами внутри платформы, Bitbucket — когда Jira и Confluence уже являются стандартом процессов. Финальный выбор обычно определяют требования к размещению данных, стоимость владения и то, насколько легко внедряются политики доступа и аудита.
Зачем нужны зеркала репозиториев и какой режим выбрать?
Зеркало помогает пережить отказ площадки, ускорить работу распределенных команд и упростить миграции между платформами. Для большинства случаев безопаснее односторонний режим, когда есть один источник истины и зеркало только читает, потому что двусторонняя синхронизация часто приводит к спорным конфликтам и усложняет контроль изменений.
Что именно нужно бэкапить в Git-платформе, кроме репозиториев?
Нужно резервировать не только git-историю, но и базу данных с правами и настройками, секреты и ключи, конфигурацию SSO, артефакты и реестр контейнеров, а также аудит-логи. Самое важное — регулярно проверять восстановление в отдельной среде и заранее согласовать целевые RPO/RTO, иначе бэкап может оказаться «бумажным».
Как навести порядок с артефактами CI/CD, чтобы потом не потерять релизы?
Определите, какие типы артефактов вы храните, где они физически лежат, кто имеет права на публикацию и чтение, и сколько времени их нужно держать. Для релизов полезно требовать проверяемую целостность через подписи или хэши и сохранять метаданные сборки, чтобы было понятно, из какого коммита и каким пайплайном сделан артефакт.
Что выбрать: SaaS, self-managed (on-prem) или гибрид?
SaaS обычно быстрее в старте и проще в обновлениях, но может не пройти требования по локализации данных и сетевым ограничениям. Self-managed дает больше контроля над данными, интеграциями и политиками ИБ, но потребует ресурсов на инфраструктуру, патчи, бэкапы и реагирование на инциденты.
Как правильно провести пилот enterprise Git-платформы, чтобы не ошибиться на проде?
Начните с короткого списка обязательных требований, затем прогоните пилот на 1–2 реальных проектах с настоящими политиками доступа, SSO, CI/CD и хранением артефактов. Если вы разворачиваете self-managed внутри своего контура, заранее спланируйте отказоустойчивость и поддержку инфраструктуры; в Казахстане это часто закрывают серверной базой уровня S200 Series и круглосуточной поддержкой через интегратора, например GSE.kz, чтобы не оставлять платформу без дежурства.
