6 мин
DCIM для серверной и мини-ЦОД: выбор по интеграциям
DCIM для серверной: как сравнить Sunbird, EcoStruxure IT и Nlyte по интеграциям с датчиками, отчетам по мощности и процедурам инцидентов.
Зачем DCIM в серверной и мини-ЦОД простыми словами
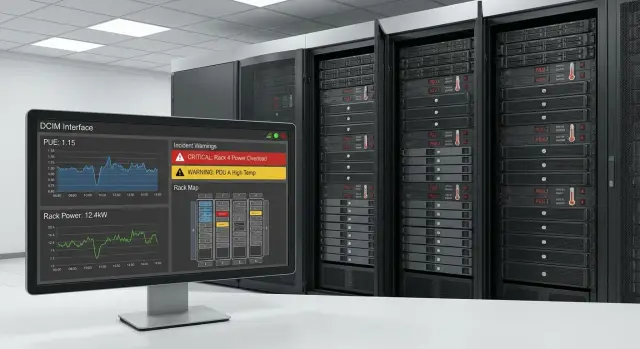
DCIM - это система, которая помогает держать серверную или мини-ЦОД в порядке: что где стоит, сколько потребляет, где перегревается, и кто должен реагировать. По сути, DCIM дает «картину в одном окне», чтобы меньше гадать и реже бегать к стойкам.
В небольших площадках многое ведут вручную: Excel по оборудованию, серийники в заметках, мощность «на глаз», инциденты - по звонкам и сообщениям. Проблемы начинаются, когда меняются люди, растет нагрузка или появляется второй шкаф. Схемы устаревают, датчики путают, подписи на портах расходятся с реальностью, а «кто последний трогал PDU» уже не вспомнить.
Практическая польза DCIM обычно сводится к четырем вещам: актуальный учет (стойки, порты, связи, датчики), контроль (температура, влажность, питание, ИБП и PDU), порядок в реакции (кто что делает и какая была история действий), и планирование (где есть запас по мощности и месту, а где вы уже близко к пределу).
Пример: в мини-ЦОД из 2-3 стоек вечером выросла нагрузка, и один PDU приблизился к лимиту. Без DCIM это часто замечают поздно - по «падает сервис» или по индикатору на месте. С DCIM видно тренд потребления, предупреждение приходит заранее, и нагрузку можно перераспределить или запланировать усиление питания без аварии.
Важно понимать границы. DCIM не заменяет ITSM (заявки, согласования, SLA) и не является полноценной BMS (глубокая автоматика здания). Но DCIM хорошо закрывает стык между ИТ и инженерией: мониторинг, учет, отчеты и понятные процедуры реакции на инциденты.
Особенности мини-ЦОД: что влияет на выбор платформы
Мини-ЦОД живет по другим правилам, чем большой дата-центр. Часто нет отдельной инженерной команды, а эксплуатацией занимаются 1-2 человека параллельно с другими задачами. Поэтому DCIM должен давать пользу быстро: без долгой настройки и регламентов, которые никто не успеет поддерживать.
В мини-ЦОД обычно важнее не «красивые карты», а управляемость: видеть датчики, питание, аварии и уметь показать простые отчеты руководству и аудиторам. Если системе нужны недели, чтобы просто начать собирать температуру и нагрузку по PDU, это тревожный сигнал.
1-2 стойки и десятки стоек - разные сценарии
Для 1-2 стоек часто достаточно понятных оповещений, пары отчетов и истории событий. На площадке с десятками стоек появляется другая нагрузка на процессы: учет емкости, стандарты именования, роли и ответственность, интеграции с заявками и календарем работ.
Для мини-ЦОД выбор чаще всего определяется приземленными вещами: поддержкой ваших датчиков и протоколов, контролем питания на уровне стойки (PDU, ИБП, вводы, фазы, лимиты, история перегрузок), быстрыми оповещениями (дежурные, эскалация, «тишина» на время работ), простыми отчетами (перегревы, запас по мощности, где нет данных) и администрированием (роли, журналы действий, резервное копирование).
Аудит и регуляторы: что не забыть
Даже в небольшой серверной часто есть требования внутреннего аудита: кто менял пороги, кто подтверждал инцидент, почему оборудование работало на пределе. Заранее уточните, сколько хранится история, есть ли неизменяемые журналы событий, как разделяются права (просмотр vs изменение), и можно ли выгружать отчеты в удобном для проверок формате.
Простой пример: ночью сработал датчик протечки. Хорошая платформа не только отправит сигнал, но и сохранит цепочку действий: кто принял тревогу, кто отключил нагрузку на PDU, и сколько времени заняло восстановление.
Интеграции с датчиками и инженерным оборудованием
DCIM ценен ровно настолько, насколько хорошо он видит реальную инженерную картину. Перед выбором составьте список источников данных, которые уже есть, и тех, что появятся в ближайший год. Обычно минимум - ИБП (нагрузка, время автономии, события), PDU (токи по фазам, иногда нагрузка по розеткам и удаленное управление), счетчики электроэнергии на вводе и по линиям, кондиционирование и вентиляция, стойки/шкафы (замки, датчики, иногда контроллеры).
Дальше важнее не логотип вендора, а способы подключения. Для «железа» чаще встречаются SNMP и Modbus (TCP/RTU через шлюз), в инженерии зданий - BACnet, для серверов - IPMI или Redfish, для обмена с другими системами - API. Заранее выясните, что поддерживается «из коробки», а где понадобятся драйверы, шлюзы или доработка.
Vendor-neutral в реальной жизни означает две вещи: система не заставляет покупать датчики и PDU только одного бренда и умеет работать в смешанной среде (например, один ИБП по SNMP, другой по Modbus, часть телеметрии через BMS, а серверные показатели через Redfish).
Как понять, что интеграция хорошая
Лучше всего проверять на пилоте. Оцените частоту опроса (обычно 30-60 секунд для мощности и температур), точность (сходимость с показаниями счетчика/ИБП), стабильность (нет ли провалов в графиках). Отдельно проверьте, как система переживает сетевые сбои: отмечаются ли пропуски данных, есть ли буфер, как ведется журнал событий.
План по датчикам логичнее строить от рисков, а не «как у всех». Для мини-ЦОД чаще всего хватает базового набора: температура и влажность у входа холодного воздуха и в горячей зоне, протечки под кондиционером и возле ввода труб/стояков, дым (интеграция с пожарной сигнализацией или отдельный датчик), события по двери (стойка и/или помещение), вибрация - если рядом лифт, генератор или стройка.
Хорошая проверка - смоделировать ситуацию: растет температура в стойке и одновременно увеличивается нагрузка на PDU. Система должна быстро показать, где именно проблема, связать сигналы и сохранить понятную историю для разбора.
Отчеты по мощности и емкости: что должно быть в системе
Отчеты в DCIM нужны не ради «красивых графиков», а чтобы быстро отвечать на простые вопросы: где заканчивается запас по питанию, что перегружается в пике, и можно ли поставить новый сервер без риска. В мини-ЦОД запас «на глаз» заканчивается внезапно.
Практичный набор обычно строится в трех разрезах: стойка, линия питания (PDU/ИБП/ввод), помещение. Важно, чтобы отчеты были одинаково понятны и инженеру, и руководителю, а цифры можно было проверить по первичным данным.
Чаще всего реально используются такие отчеты: по стойке (текущая нагрузка, пик за период, запас до порогов, перекос по фазам), по PDU и линиям (распределение нагрузки, перегруженные группы, история перегрузок), по ИБП (вход-выход, время автономии при текущей нагрузке, состояние батарей - если поддерживается), по помещению (суммарное потребление, тренды, связь с температурой), по емкости (сколько «ваттного места» осталось в стойке и на вводе).
Смотрите не только «сейчас», но и пики и тренды. Среднее потребление часто выглядит безопасно, а перегруз случается по понедельникам утром или во время резервного копирования.
Пороги и предупреждения стоит настроить в первую очередь, иначе будет либо тишина, либо сотни бесполезных уведомлений. Обычно начинают с предупреждения при 70-80% лимита цепи или PDU и критики при 90-95% (по вашей политике), плюс контроль перекоса фаз и перегрева в стойке. Если есть «плановые пики» (ночные задачи), их лучше учитывать отдельными правилами.
Для планирования емкости полезна простая модель «добавить сервер». Система должна показать, куда он проходит по стойке, PDU, ИБП и вводу, и какой останется запас. Пример: новый узел потребляет 600 Вт - в стойке запас есть, но конкретная ветка PDU уже близко к лимиту, значит нагрузку надо перекинуть.
Отдельный вопрос - экспорт. Руководству обычно нужны короткие отчеты в PDF или таблице, техслужбе - выгрузка сырых данных (CSV) и регулярные отчеты по расписанию.
Процедуры инцидентов и эксплуатация: как это должно работать
DCIM полезен не только графиками. Он должен помогать дежурному быстро понять: что случилось, где это произошло и что делать дальше. Для этого нужен одинаковый для всех цикл инцидента и четкие роли.
Цикл инцидента без хаоса
Нормальная схема выглядит так: система фиксирует событие, ответственный подтверждает (не ложное ли срабатывание), дальше выполняются действия по инструкции, после чего инцидент закрывают с причиной и зафиксированными шагами.
Оповещения должны приходить в каналы, которыми реально пользуются: почта для подробностей, SMS для критичных тревог, мессенджер для быстрого обмена. Если есть Service Desk, полезна автоматическая заявка с привязкой к стойке/устройству, текущими показаниями и приоритетом.
Эскалации тоже стоит формализовать: если критический инцидент не подтвердили за 5-10 минут, он уходит на следующий уровень (старший инженер, руководитель смены, подрядчик).
Журналы и аудит - обязательны: должно быть видно, кто менял пороги, кто отключал уведомления, кто закрывал инцидент. Это помогает разбирать причины, а не искать виноватых.
Типовые сценарии
Чтобы реагировать быстрее, заведите карточки хотя бы для перегрева, перегруза по фазе/линии, отказа датчика (нет данных, скачки), потери связи с устройством мониторинга и повторяющихся ложных срабатываний.
Пример: при росте температуры система поднимает приоритет, создает заявку, отправляет SMS дежурному и прикладывает историю датчика. Дежурный видит, что проблема локальна в одной стойке, и действует по шаблону.
Sunbird, EcoStruxure IT и Nlyte: как сравнивать без рекламы
Сравнивать платформы проще, если заранее выбрать главные критерии: скорость внедрения, глубина интеграций с датчиками и инженерией, удобство отчетов по мощности и емкости, поддержка процессов и ролей.
EcoStruxure IT часто рассматривают, когда нужно быстро получить мониторинг и алерты в связке с типовыми сценариями и экосистемой Schneider Electric. Sunbird нередко выбирают за понятные дашборды и практичные отчеты по стойкам (когда важно быстро отвечать на вопросы по перегреву и питанию). Nlyte обычно смотрят, если важны процессы, роли, контроль изменений и дисциплина эксплуатации в более крупных средах.
Чтобы сравнение было честным, задайте всем одинаковые вопросы: как устроено лицензирование, что происходит при росте объектов, какие интеграции есть «из коробки», где потребуются шлюзы/драйверы, как сделаны роли и права, есть ли API и готовые шаблоны отчетов по мощности, емкости и инцидентам.
На демо просите показывать не «красивый экран», а цепочку: событие от датчика - инцидент - назначение ответственного - журнал действий - отчет по времени реакции.
И отдельно проверьте риск привязки к одному производителю: поддержка смешанного парка (PDU, UPS, датчики, BMS) и нормальный экспорт данных обычно важнее маркетинговых обещаний.
Пошаговый выбор и пилот: от требований до приемки
Чтобы выбрать DCIM без сюрпризов, начинайте не с вопроса «что лучше», а с того, какие данные вы реально сможете собрать и как будете ими пользоваться. Пилот на 1-2 стойках почти всегда экономит время и быстро показывает качество данных.
Минимальный план работ на 2-4 недели
-
Соберите инвентарь и схему электропитания: от ввода до ИБП, PDU и отдельных линий. Важно понимать, где есть реальные измерения, а где будут расчетные цифры.
-
Опишите датчики и места установки конкретно: в каких стойках, на какой высоте, сколько точек, что уже есть по интерфейсам (Modbus, SNMP, сухие контакты).
-
Согласуйте короткий набор результатов на пилот: несколько ключевых отчетов и оповещений (например, загрузка PDU по фазам, запас по ИБП, превышение температуры в верхней части стойки, потеря связи с датчиком).
-
Проведите пилот и сверьте показания: DCIM против данных на PDU/ИБП и против ручных измерений. Если расхождения больше 5-10%, сначала чините источник данных, а не «рисуете отчеты».
-
Зафиксируйте критерии приемки и план расширения: темпы добавления стоек, кто отвечает за внесение активов, как обновляются схемы и пороги.
Что считать успешной приемкой
Ориентир простой: дежурный открывает один экран и понимает, где перегрев, где перегруз по питанию и какие следующие шаги.
Минимальный набор проверок на приемке:
- точность мощности и корректность единиц измерения;
- стабильность интеграций (датчики не «отваливаются» регулярно);
- время доставки критичных оповещений и понятный текст тревоги;
- воспроизводимые процедуры (кто и что делает по шагам).
Если мини-ЦОД находится в госорганизации или банке, пилот лучше проводить на типовой нагрузке: виртуализационные хосты, СХД, сеть. Так быстрее видно, хватит ли интеграций и как система поведет себя при масштабировании.
Типичные ошибки при выборе и внедрении DCIM
Частая причина разочарования - ожидание, что платформа сама наведет порядок. DCIM помогает видеть картину и управлять процессами, но ему нужны исходные данные, правила и дисциплина.
Ошибки, которые чаще всего обходятся дорого: покупают систему до наведения порядка в инвентаре и маркировке; ставят много датчиков, но не договариваются о порогах и реакции (в итоге алерты превращаются в шум); не фиксируют процедуры и эскалации; ждут, что DCIM решит проблемы электрики и охлаждения (он только покажет риск); игнорируют роли доступа и аудит изменений, из-за чего потом сложно понять, почему «сломались» отчеты.
Короткий пример: подключили датчики температуры и протечек, но пороги сделали слишком чувствительными. Ночью пришло 40 уведомлений, дежурный отключил звук, а утром пропустили реальный перегрев из-за забитого фильтра. Проблема была не в датчиках, а в правилах: что критично, что предупреждение, кто отвечает за каждую группу.
Хороший самотест: сможете ли вы без DCIM быстро ответить, что где стоит, от чего питается, какие лимиты по стойке и кто принимает решение при аварии. Если ответы расплывчатые, начните с учета, ролей и простых регламентов, а затем расширяйте интеграции.
Короткий чек-лист перед покупкой и запуском
Этот список помогает быстро отсеять решения, которые красиво выглядят на демо, но дают сбои в эксплуатации.
Перед покупкой
Попросите не презентацию, а подтверждения на похожих условиях:
- какие протоколы и драйверы поддерживаются (SNMP, Modbus, IPMI и другие) именно для ваших ИБП, PDU, кондиционеров и датчиков;
- как выглядят отчеты по мощности и емкости на уровне стойки, включая пики и тренды;
- можно ли настроить пороги без сложной доработки;
- есть ли роли пользователей и аудит действий.
Потом попросите показать типовую ситуацию целиком: ночью выросла температура в одной стойке, дежурный получил уведомление, увидел историю, зафиксировал действия и закрыл инцидент.
Перед запуском (пилот и приемка)
На пилоте важнее стабильность данных и понятные оповещения:
- сбор телеметрии без «дыр» и скачков, ясная диагностика, если датчик пропал или сменился адрес;
- эскалации и расписания дежурств, чтобы уведомления не уходили «в никуда»;
- понятные правила закрытия инцидентов и фиксация шагов;
- сверка отчетов по мощности с данными PDU/ИБП и счетчиков.
Если работаете с интегратором, заранее зафиксируйте критерии приемки: какие датчики подключены, какие отчеты обязательны, какие уведомления должны прийти в тестовых сценариях.
Пример: мини-ЦОД в организации с критичными сервисами
Мини-ЦОД в больнице: 6 стоек, часть систем работает круглосуточно (регистратура, лаборатория, архив снимков). Простой даже на 10 минут вызывает очереди и риски для пациентов. Инженерная часть компактная, но нагрузка плотная: ИБП, PDU в стойках, кондиционирование, датчики температуры и влажности.
Проблемы проявляются не одним большим сбоем, а мелкими симптомами. Одна стойка перегревается после обеда, когда растет нагрузка на виртуализацию. Раз в неделю появляется предупреждение по перегрузу на одной фазе: оборудование добавляли постепенно, и баланс по питанию «уплыл».
DCIM связывает «что стоит где» с показаниями датчиков и электропитания. По стойкам видно, что горячие точки совпадают с плотными серверами в середине и плохим проходом воздуха. Уведомление приходит не просто «температура высокая», а с привязкой к стойке, высоте юнитов и времени, когда начался рост.
Дальше важна повторяемость. Дежурный получает тревогу, открывает карточку стойки и действует по шаблону: подтверждает показания (температура, нагрузка по фазам, статус кондиционера), фиксирует время начала и затронутые системы, выполняет безопасные действия (проверка воздушных потоков, перенос нагрузки, включение резервного охлаждения), отмечает результат и закрывает инцидент с причиной и рекомендациями.
Через неделю отчеты по пикам мощности показывают, что перегруз совпадает с резервным копированием и вечерними обновлениями. Решение становится понятным и проверяемым: переразместить два сервера по стойкам, задать лимиты на PDU, для проблемной стойки поправить охлаждение и добавить датчик на задней двери.
Следующие шаги: как перейти от выбора к стабильной работе
Чтобы DCIM не превратился в красивую, но бесполезную панель, начните с точных исходных данных: список стоек и устройств, схема питания (вводы, ИБП, PDU), перечень датчиков (температура, влажность, протечки, дверь) и список ответственных за электрику, сеть и серверы.
Выберите одну платформу для пилота и заранее договоритесь, что будет считаться успехом. Пилот лучше делать на 1-2 стойках и одном типовом инженерном контуре, где есть и нагрузка, и риск (например, стойка с виртуализацией и ИБП).
Критерии успеха удобно формулировать так, чтобы их можно было проверить за неделю: датчики и PDU дают корректные показания и события не теряются; отчеты по мощности сходятся с измерениями на стороне ИБП или счетчика; инцидент фиксируется, назначается ответственный и остается понятная история действий; есть видимый запас по емкости, чтобы понимать, что можно добавить без перегруза.
После пилота нужен короткий план внедрения, иначе система быстро «умирает». В нем стоит закрепить порядок подключения датчиков и интеграций, роли пользователей, обучение дежурных и правила ведения справочников (стойки, активы, локации).
Помогает простой регламент, который реально выполнять: любое изменение в стойке сопровождается заявкой и обновлением данных; новое оборудование не вводится без фиксации в DCIM; раз в месяц проводится сверка активов и ключевых датчиков; для тревог задан список контактов и время реакции, включая ночные смены.
Если нужен партнер, который закрывает интеграцию целиком (железо, инфраструктура, внедрение и поддержка), можно рассмотреть GSE.kz (gse.kz) как системного интегратора: у компании есть опыт построения ИТ-инфраструктуры и круглосуточная техподдержка, что помогает довести DCIM до стабильной эксплуатации, а не ограничиться установкой ПО.
Частые вопросы
Что такое DCIM простыми словами?
DCIM собирает в одном месте данные о стойках, оборудовании, питании, температуре, датчиках и событиях. Он помогает быстро понять, где возник риск перегрева или перегрузки, и кто уже отреагировал.
Нужен ли DCIM для мини-ЦОД из одной или двух стоек?
Да, если у вас есть критичные сервисы, ИБП, PDU или несколько источников телеметрии. Для 1-2 стоек обычно достаточно базового набора: мониторинг температуры и питания, оповещения, история событий и простой отчет по запасу мощности.
Какие устройства стоит подключить к DCIM в первую очередь?
Сначала подключите ИБП, PDU, счетчики, датчики температуры и влажности, протечки и события дверей. Затем добавляйте кондиционирование, серверные данные и другие источники, которые влияют на реакцию при аварии.
Как проверить совместимость DCIM с датчиками и ИБП?
Проверьте, поддерживает ли платформа ваши устройства и способы связи: SNMP, Modbus, BACnet, IPMI, Redfish и API. Лучше провести пилот на реальных ИБП, PDU и датчиках, а не ориентироваться только на список совместимости.
Как часто DCIM должен собирать данные?
Для мощности и температуры обычно подходит опрос раз в 30-60 секунд. Во время пилота сравните показатели DCIM с экраном ИБП, PDU, счетчиком и ручными измерениями. Если цифры заметно расходятся, сначала проверьте источник данных и единицы измерения.
Какие отчеты по мощности нужны в мини-ЦОД?
Минимум: текущая и пиковая нагрузка по стойкам и PDU, запас до лимитов, перекос фаз, состояние ИБП, температура и тренды потребления. Отчет должен показывать, можно ли безопасно добавить новый сервер и на какую линию его подключить.
Какие пороги предупреждений лучше настроить?
Начните с предупреждения при 70-80% лимита линии или PDU и критического уровня при 90-95%, если это соответствует вашей политике. Отдельно настройте тревоги по перегреву, потере связи с датчиком, протечке и перекосу фаз.
Как DCIM помогает реагировать на инциденты?
Система должна зафиксировать событие, уведомить дежурного, показать стойку и текущие показания. Дежурный подтверждает тревогу, действует по инструкции, записывает причину и выполненные шаги, затем закрывает инцидент.
Чем отличаются Sunbird, EcoStruxure IT и Nlyte?
EcoStruxure IT часто подходит для быстрого мониторинга и оповещений, особенно при использовании оборудования Schneider Electric. Sunbird удобен для обзора стоек и отчетов по питанию и температуре. Nlyte чаще рассматривают там, где нужны строгие роли, контроль изменений и более формальные процессы. Сравнивайте их на одинаковом пилотном сценарии.
Как провести пилот DCIM перед покупкой?
Пилот можно провести за 2-4 недели на 1-2 стойках. Подключите типовые устройства, настройте несколько тревог и отчетов, затем проверьте точность данных, доставку уведомлений, историю действий и расчет запаса мощности. Зафиксируйте критерии приемки до начала работ.
