7 мин
Замена коммерческого прокси на Squid: кэш, ACL, логи и TLS
Замена коммерческого прокси на Squid: план миграции, кэширование, ACL, логи и TLS-инспекция где допустимо, плюс меры, чтобы не ломать важные веб-сервисы.
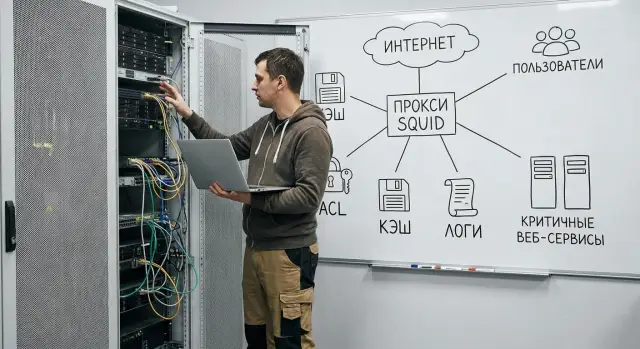
Зачем вообще менять прокси и что можно сломать
Коммерческий прокси часто решает сразу несколько задач: контроль доступа в интернет, учет и расследования по логам, базовую защиту от вредных доменов, а иногда еще и удобную авторизацию (AD/LDAP/SSO), отчеты для ИБ и готовые политики. При замене коммерческого прокси на Squid важно не просто поставить новый сервер, а сохранить именно те функции, которые реально используются каждый день.
Причины замены обычно простые. Лицензии дорожают, условия меняются, а правила и исключения остаются внутри «черного ящика», который сложно объяснить аудитору или даже себе через полгода. Добавьте зависимость от вендора и сложности с поддержкой, и становится понятно, почему компании выбирают более прозрачный вариант.
Прокси - точка, через которую проходит критичный трафик. Ошибки при миграции часто проявляются не сразу, а как «странные» сбои у пользователей и сервисов. Чаще всего страдают авторизация и SSO (петли входа, запросы пароля, неожиданные 407), бизнес-сайты с жесткими требованиями к TLS (пиннинг сертификатов, mTLS, банковские кабинеты), обновления ОС и антивирусов (репозитории и облака), а также видеозвонки и мессенджеры (WebRTC, нестандартные порты, большие потоки). Отдельная зона риска - интеграции, где прокси прописан в приложении или задан через PAC/WPAD.
Риск не только в блокировках. Бывает и наоборот: часть трафика внезапно идет мимо правил, а в логах нет картины для расследования.
Заранее предупредить нужно не только ИТ. Обычно вовлечены ИТ-эксплуатация (сети, AD, рабочие места), ИБ (политики, требования по логам, допустимость TLS-инспекции), владельцы ключевых сервисов (ERP, бухгалтерия, гос-порталы, платежи) и служба поддержки, чтобы она отличала реальный инцидент от «переезда».
Простой пример: в госорганизации доступ к порталам и ЭЦП может опираться на строгий TLS, а бухгалтерия зависит от внешнего банка. Если заранее не договориться об исключениях и тестах, миграция превращается в череду срочных просьб «разрешите вот это прямо сейчас».
Подготовка: требования, инвентаризация, критерии успеха
Перед тем как начинать замену коммерческого прокси на Squid, важно договориться о целях и границах. Большинство сбоев случается не из-за синтаксиса конфигурации, а из-за того, что никто заранее не описал, что считается нормальной работой, а что - инцидентом.
Начните с требований. Недостаточно формулировки «нужен интернет через прокси». Уточните, кто ваши пользователи (офис, филиалы, удаленные), какие приложения ходят в сеть (браузеры, обновления ОС, ERP, ВКС), и какие есть ограничения: регуляторные правила, хранение логов, запрет на расшифровку трафика, необходимость белых списков.
Сразу зафиксируйте критичные сервисы, которые нельзя ломать: банк-клиент, госзакупки, ЭДО, порталы поставщиков, видеоконференции, медицина (МИС), обучение (LMS). У бухгалтерии может быть портал, который работает только при прямом TLS без подмены сертификатов, а у колл-центра - веб-телефония, чувствительная к задержкам.
Инвентаризация занимает меньше времени, чем разбор полетов потом. Соберите то, что уже есть в текущем решении: правила доступа, исключения, расписания, списки доменов и категорий, отчеты по блокировкам, типовые жалобы пользователей. Отдельно выпишите «серые зоны»: правила, смысл которых никто не помнит, и исключения «на всякий случай».
Минимум, который стоит собрать до первой тестовой установки:
- подсети и группы пользователей, которые пойдут через прокси
- критичные домены и IP (включая внешние API и SaaS)
- текущие правила блокировок и исключений
- требования к хранению логов и доступу к ним
- приложения, которые не умеют работать через прокси
Критерии успеха
Критерии должны быть измеримыми. Иначе миграция превращается в спор «кажется стало хуже».
Понятный набор критериев:
- доступность: ключевые сервисы открываются и проходят авторизацию
- задержки: страницы и веб-приложения не стали заметно медленнее в часы пик
- качество журналов: видно кто, куда и когда ходил, и по какой причине было отказано
- соблюдение политики: блокировки работают предсказуемо, без случайных запретов
- безопасность: TLS-инспекция включена только там, где она разрешена и согласована
В конце выберите сценарий перехода. Почти всегда безопаснее параллельный запуск: новый Squid обслуживает пилотную группу или один филиал, а остальная сеть остается на старом прокси. Переключение «в один момент» оправдано только если конфигурация проста, инвентаризация полная, а откат быстрый (например, возврат маршрутизации или PAC-файла за 5-10 минут).
Архитектура внедрения Squid простыми словами
Squid можно поставить по-разному, и от этого зависит, насколько спокойно пройдет миграция. Самый понятный вариант для старта - отдельный сервер или виртуальная машина, которая принимает трафик пользователей и ходит в интернет от их имени. Так проще оценивать нагрузку, переносить настройки и быстро откатываться.
Если трафика много или прокси становится критичной точкой, закладывайте минимум два узла. Это не обязательно сложный кластер: часто достаточно пары одинаковых Squid и способа переключения при сбое (виртуальный IP, балансировщик или быстрый перевод клиентов на второй адрес). Важно, чтобы оба узла имели одинаковые правила и одинаковый доступ в сеть.
Явный прокси или прозрачный режим
Для управляемой миграции чаще проще явный прокси. Устройства получают адрес и порт прокси через политику, профиль, MDM или настройки браузера. Тогда вы точно знаете, кто и куда ходит, и можете поэтапно переводить группы пользователей.
Прозрачный режим выглядит заманчиво (ничего не настраивать на клиентах), но чаще приносит сюрпризы: сложнее отлаживать, больше рисков поломать часть сайтов, и труднее объяснить приложениям, что трафик идет через прокси. Для первого внедрения его обычно оставляют на потом, когда уже понятны исключения и поведение сервисов.
Разделение ролей, чтобы не запутаться
Squid должен заниматься проксированием, а не всем сразу. Держите рядом, но отдельно, ключевые сервисы: DNS (быстрый и предсказуемый), каталог пользователей (AD/LDAP) для групп и правил доступа, сбор логов (syslog, SIEM или отдельный сервер) и мониторинг доступности (проверки портов, задержек, заполнения диска кэша).
Простой пример: вы переводите сначала бухгалтерию на явный прокси. Если у них перестал открываться банк-клиент, вы быстрее поймете, это DNS, правило доступа, проблема с сертификатом или домен, которому нужно исключение. Когда роли разделены, поиск причины занимает минуты, а не дни.
В целом архитектура должна отвечать на три вопроса: где стоит Squid, как пользователи на него попадают, и что будет, если узел упадет. Если это продумано заранее, дальше проще обсуждать кэш, ACL и логи без риска для критичных веб-сервисов.
Пошаговая миграция без остановки работы
Надежная миграция - это не «одна ночь и переключили», а серия маленьких проверяемых шагов. В любой момент вы должны уметь вернуться на старый прокси за минуты.
Начните с отдельного тестового Squid, который не влияет на основную работу. Подключите к нему небольшую группу: ИТ-отдел, пару «тяжелых» пользователей (кто часто работает с веб-приложениями) и хотя бы одного человека из бухгалтерии или закупок. Это даст быстрые сигналы о проблемах, которые не видны в лаборатории.
Дальше перенесите базовые правила доступа «как есть». На старте не пытайтесь улучшать логику, объединять списки и «наводить красоту». Чем меньше отличий от текущего поведения, тем меньше сюрпризов. Сфокусируйтесь на трех вещах: кто может ходить в интернет, какие домены точно нужны для работы, и какие ограничения уже действуют (например, запрет на анонимайзеры или торренты).
Кэширование включайте осторожно и только после того, как доступ стабилен. Хорошая практика - начать с консервативных настроек и измерять эффект: что ускорилось, где выросла нагрузка, какие сервисы начали вести себя странно. Часть современных SaaS и банковских кабинетов кэшировать бессмысленно, а иногда вредно.
Когда пилот работает ровно, расширяйте аудиторию по подразделениям. После каждого расширения фиксируйте изменения: что добавили в правила, какие исключения сделали, какие домены внесли в allowlist. Это дисциплинирует и помогает разбирать жалобы, которые приходят «через две недели после переключения».
Параллельно подготовьте план отката и проверьте его на практике:
- что именно переключаем назад (PAC-файл, DHCP/AD политики, настройки браузеров)
- кто отвечает за откат и кто подтверждает восстановление работы
- какие метрики показывают, что «стало плохо» (рост 407/403, жалобы на конкретные сервисы)
- сколько времени занимает возврат в штатный режим
Если ваша цель - замена коммерческого прокси на Squid, секрет успеха простой: меняйте только один параметр за раз и всегда держите быстрый откат.
Кэширование: где помогает, а где мешает
Кэш в Squid полезен там, где одни и те же файлы скачиваются многими людьми и почти не меняются. В офисной сети это часто дает заметный эффект: меньше внешнего трафика, быстрее повторные загрузки, меньше пиковых задержек. Но кэш может и навредить, если хранить то, что должно быть всегда свежим или персональным.
Проще начинать консервативно: кэшировать только явно безопасный статичный контент, а остальное оставлять как есть. При замене коммерческого прокси на Squid это снижает риск жалоб на «устаревшие данные» и странные ошибки в веб-приложениях.
Обычно безопаснее кэшировать обновления ОС и приложений, репозитории пакетов, статические файлы (изображения, стили, скрипты, публичные шрифты), дистрибутивы, а также внутренние порталы со статикой, если контент обновляется по расписанию.
А вот личные кабинеты, банковские и платежные страницы, госресурсы, медицинские системы, динамические веб-приложения (ленты, чаты), API-запросы и любые сценарии с авторизацией, токенами и индивидуальными ответами чаще всего лучше исключать из кэша правилами.
Чтобы понимать, что происходит, держите в голове четыре термина: размер кэша (сколько места на диске), TTL (как долго объект считается пригодным), hit (ответ отдан из кэша) и miss (Squid пошел в интернет). На практике важен не «красивый конфиг», а баланс: лучше меньше кэша, но без сюрпризов.
Проверяйте пользу простыми наблюдениями: растет ли доля hit по статике, уменьшается ли внешний трафик в часы пик, нет ли всплеска ошибок в журналах и жалоб на «старые версии» или проблемы входа. Если жалобы появились, первым делом отключайте кэш для проблемного домена или типа URL, и только потом тонко настраивайте TTL.
ACL в Squid: как сделать правила понятными и живучими
ACL в Squid легко превратить в клубок исключений, если добавлять их «по запросу» и без структуры. Понятные правила обычно выглядят скучно: они разложены по смыслу, подписаны и меняются редко. Это особенно важно при замене коммерческого прокси на Squid, когда вы хотите получить контроль, а не новый источник рисков.
Начните с базовой структуры: отдельно описывайте пользователей и группы, отдельно категории ресурсов, отдельно исключения. В конфиге это часто означает отдельные файлы или блоки, где каждое правило отвечает на один вопрос: «кто?», «куда?», «как?». Тогда при инциденте вы ищете не «почему сломалось», а «какая группа и какой ресурс».
Принцип наименьших прав лучше внедрять порядком действий:
- сначала разрешите обновления ОС и антивируса, корпоративные DNS и NTP (если они идут через прокси)
- затем разрешите основные рабочие веб-сервисы только нужным группам
- в конце явно запретите «все остальное»
- новые разрешения добавляйте через именованные ACL и с коротким комментарием «зачем»
Критичные сервисы держите отдельным слоем. У многих организаций это госпорталы, ЭДО, банковские кабинеты, платежные шлюзы, облачные офисы, сервисы MFA. У этих ресурсов строгие требования к TLS, куки и редиректам, поэтому им полезны отдельные ACL и понятный способ временного обхода на случай сбоя. Пример: вместо «разрешить все для бухгалтера» заведите группу users_accounting и ACL bank_portals, и разрешите только их пересечение.
Исключения оформляйте так, чтобы через месяц было ясно, кто их попросил и можно ли удалить. У исключения должен быть владелец и дата пересмотра. Без этого оно почти всегда становится вечной дырой.
Отдельно держите доступ по времени и гостевые устройства. Для гостей обычно проще иметь отдельный набор правил: меньше прав, ограниченные категории и, при необходимости, ограничение по времени. Для экстренных случаев полезна отдельная break-glass группа с жестким учетом и быстрым отключением.
Журналирование: чтобы расследовать инциденты, а не гадать
При замене коммерческого прокси на Squid логи замечают в первую неделю. Когда у пользователя «не открывается сайт», именно журналирование показывает, что произошло: блок по ACL, ошибка DNS, отказ по сертификату, таймаут или проблема на стороне сервиса.
Минимум обычно включает три слоя. Access log отвечает на вопрос «кто и куда ходил» (IP/логин, метод, код ответа, время). Cache.log помогает видеть ошибки Squid, перезапуски, проблемы с диском, памятью и DNS. Отдельно полезны события отказов: причины блокировок (по домену, времени, аутентификации) и признаки подозрительной активности (частые 407, всплески запросов, много CONNECT на нестандартные порты).
Чтобы не утонуть в данных, заранее договоритесь о формате и «карте полей». Обычно достаточно фиксировать: исходный IP, пользователя (если есть auth), домен или SNI (если возможно), URL, код ответа, объем, время и причину отказа. Тогда по инциденту вы делаете короткую выборку без чтения гигабайтов.
Перед запуском согласуйте хранение и доступ. Принцип простой: хранить достаточно, чтобы закрывать расследования, и ограничить доступ так, чтобы логи не стали источником утечек. Назначьте владельца логов, порядок выдачи выгрузок и кто имеет право видеть персональные данные.
ИБ обычно интересуют четыре вещи: кто обращался к домену в конкретное время и пытался ли обходить через CONNECT; почему запрос заблокирован и какое правило сработало; были ли массовые обращения к подозрительным доменам; есть ли контроль целостности и кто может менять настройки логирования.
Проверьте пользу логов на простом сценарии. Например, в больнице или госоргане перестал открываться портал поставщика. За 10 минут соберите цепочку «пользователь - домен - код - причина», подтвердите или исключите блокировку и сформируйте короткий отчет. Если для этого нужны догадки и ручные обходы, значит формат полей или уровни логов выбраны неудачно.
TLS-инспекция: где допустимо и как не нарушить правила
TLS-инспекция (SSL-bump) - это когда прокси не просто пропускает зашифрованный трафик, а временно расшифровывает его внутри периметра, проверяет по правилам (DLP, антивирус, категории), а затем снова шифрует до сайта. Без инспекции при HTTPS обычно видны только метаданные: куда идет соединение, но не содержимое.
Технически это требует корпоративного корневого сертификата на рабочих устройствах: браузер начинает доверять сертификатам, которые прокси выпускает на лету. Без этого вы получите массовые ошибки сертификатов.
Дальше вопрос упирается в допустимость. Если это корпоративные устройства и в правилах использования прямо сказано, что трафик может проверяться, риски ниже. На практике инспекция чаще уместна на управляемых устройствах (MDM/AD) при утвержденной политике, в сегментах с повышенными требованиями (учебные классы, общие терминалы, гостевые сети), а также для конкретных категорий по инцидентам, а не «для всего подряд». И почти всегда - сначала пилот на небольшой группе.
Есть зоны, где инспекция часто приносит больше проблем, чем пользы, и может быть юридически чувствительной: финансы (банки, эквайринг), медицина, госресурсы, личные почты и мессенджеры, а также сервисы, где по правилам нельзя перехватывать содержимое. Даже если технически получится, это может нарушить внутренние регламенты, договоры или требования комплаенса.
Из типовых поломок: приложения с certificate pinning (часть банковских клиентов, мессенджеры, апдейтеры), ошибки входа в SSO, капчи и бесконечные редиректы, сбои API у бизнес-систем. Внешне это выглядит как «сайт не открывается», хотя сеть жива.
Самый безопасный подход при замене коммерческого прокси на Squid - точечная инспекция плюс большой список исключений:
- начните со splice (без расшифровки) для всего, а bump включайте только для выбранных доменов или категорий
- сразу исключите банки, платежи, медицину, госресурсы, обновления ОС и критичные облака
- держите отдельную группу тест-пользователей и быстрый откат (флаг в ACL или отдельный порт)
- логируйте факт блокировки и причину, но не собирайте лишнее содержимое
- согласуйте политику с ИБ и юристами до включения в прод
Если после включения инспекции растет число TLS-ошибок и жалоб, не пытайтесь «дожать» настройками. Чаще правильнее расширить исключения и оставить инспекцию только там, где она дает понятную пользу и не ломает бизнес-сервисы.
Как не сломать критичные веб-сервисы: практические приемы
Критичные веб-сервисы ломаются не из-за Squid как такового, а из-за мелочей: неожиданной аутентификации, запрета методов, перехвата TLS, таймаутов или несовпадения правил. Поэтому перед заменой коммерческого прокси на Squid лучше заранее договориться, что именно нельзя уронить и кто подтверждает, что «все работает».
Начните со списка критичных сервисов и владельцев. Для каждого сервиса зафиксируйте бизнес-владельца, технического владельца, окно, когда можно тестировать, и критерий успеха. Примеры критериев: «логин через SSO проходит», «подпись документа работает», «API отвечает не хуже 300 мс на 95-м перцентиле».
Проверки, которые стоит сделать до массового включения
Соберите короткий набор тестов и прогоните его на пилотной группе (10-20 пользователей или один офис), а не сразу на всех. Проверьте вход (SSO, OAuth, MFA, порталы с CAPTCHA), передачу данных (загрузки и скачивания больших файлов, облачные диски), сценарии реального времени (видеозвонки, чаты, WebSocket), спецфункции (ЭЦП, криптопровайдеры, госкабинеты, банковские порталы) и интеграции (служебные API, вебхуки, обновления антивирусов, агенты управления).
Типовые признаки проблем обычно повторяются: SSO крутится по кругу, OAuth возвращает 403/429, CAPTCHA появляется бесконечно, WebSocket обрывается каждые 30-60 секунд, обновления не доходят из-за блокировки доменов или нестандартных путей.
Как быстро диагностировать и чинить
Держите возможность сравнить поведение «старый прокси vs новый прокси». Лучше всего иметь тестовую машину, где переключение делается за минуту (через отдельную группу, PAC/настройку браузера или временное исключение).
При инциденте фиксируйте три вещи: URL или хост, точное время, имя пользователя или подсеть. По логам смотрите коды (TCP_DENIED/403, 407, 502/504), размер ответа и время. Если через старый прокси работает, а через новый нет, чаще всего виноваты ACL (не разрешили CONNECT к нужному порту или домену), TLS-инспекция (нельзя для части сервисов) или слишком жесткие таймауты.
На первые 3-5 дней запланируйте режим повышенной готовности: окно изменений, быстрый канал обратной связи и заранее подготовленный план отката. Полезно назначить одного ответственного, кто принимает решения по временным обходам (например, исключение домена из проверки или прямой доступ), чтобы критичные сервисы не простаивали часами.
Быстрые проверки и следующие шаги
Перед финальным переключением на Squid полезно сделать короткую паузу и пройтись по проверкам. Это снижает риск внезапных сбоев в почте, банках, госресурсах или внутренних веб-системах.
Перед переключением: 10 минут, которые экономят часы
Убедитесь, что вы понимаете, что именно произойдет в момент переключения, и базовые вещи готовы:
- ACL проверены: кто и куда ходит, есть ли отдельные правила для серверных подсетей и админских устройств
- исключения согласованы: банки, SSO/IdP, обновления ОС и антивирусов, видеоконференции, API партнеров
- логи включены и понятны: access.log, cache.log, хранение и срок, синхронизация времени (NTP)
- мониторинг готов: доступность прокси, CPU/RAM/диск, место под кэш и логи, число ошибок
- план отката записан: как вернуть старый маршрут или настройки PAC/WPAD, кто делает, сколько это занимает
После этого сделайте контрольный прогон на тестовой группе (один отдел или филиал): откройте 5-10 критичных сайтов, проверьте вход в корпоративные сервисы и скачайте крупный файл, чтобы увидеть поведение кэша и таймаутов.
После переключения: что смотреть в первые часы
Сразу после перевода трафика не рассчитывайте на полную тишину. Важно быстро отличить системную проблему от единичных случаев. Собирайте обратную связь (почта, ЭДО, интернет-банк, госпорталы, видеосвязь), смотрите метрики (рост 4xx/5xx, увеличение таймаутов, всплеск CONNECT), проверяйте топ ошибок из cache.log (DNS, TLS handshake, denied, auth, сертификаты) и убеждайтесь, что исключения для критичных доменов и обновлений реально работают.
Если ошибка повторяется, фиксируйте: время, IP пользователя, домен, код Squid и фрагмент из access.log. Это заметно ускоряет поиск причины.
Дальше обновите документацию: какие подсети ходят через прокси, где лежат ACL и исключения, кто утверждает изменения, как добавлять новый сервис без риска открыть лишнее. Затем переходите к плановым улучшениям: настройка кэша там, где он дает реальную пользу, чистка устаревших правил, регулярные отчеты по топ-доменам и отказам.
Если для проекта нужны серверы под прокси, логи и смежные задачи (например, размещение рядом с другой инфраструктурой или требования к поддержке), это часто удобно решать через GSE.kz: для таких ролей обычно подходят стойковые серверы S200, а команда системной интеграции может помочь собрать решение под вашу схему и требования.
Частые вопросы
Зачем вообще менять коммерческий прокси на Squid?
Меняют, когда лицензии и поддержка становятся слишком дорогими или непредсказуемыми, а правила доступа остаются в «черном ящике». Squid выбирают за прозрачность: вы точно видите, какие ACL и исключения действуют, и можете объяснить это ИБ и аудиторам. Главное — переносить не «сервер», а реально используемые функции: авторизацию, отчеты, логи и критичные исключения.
Что чаще всего ломается при миграции на Squid?
Чаще всего «сыпется» авторизация (SSO, 407, петли входа), сайты с жестким TLS (пиннинг, mTLS, банк-клиенты), обновления ОС и антивирусов, а также видео и мессенджеры (WebRTC, нестандартные порты, большие потоки). Еще одна частая проблема — приложения, где прокси прописан вручную или задан через PAC/WPAD, и вы забыли про эти точки.
С чего начать подготовку перед переходом на Squid?
Начните с требований и инвентаризации: кто пользователи, какие приложения ходят наружу, какие ограничения по TLS-инспекции и логам, какие домены критичны. Затем зафиксируйте критерии успеха в измеримых терминах: ключевые сервисы открываются и проходят вход, задержки не выросли заметно в часы пик, логи дают понятную причину отказа. Без этого любые жалобы превращаются в спор «стало хуже или кажется».
Что лучше для миграции: явный прокси или прозрачный режим?
Для первого внедрения обычно проще явный прокси, потому что вы точно управляете тем, кто уже переведен, и можете быстро откатить конкретную группу. Прозрачный режим сложнее в отладке и чаще дает неожиданные сбои с HTTPS и приложениями, которые «не ожидали» прокси на пути. Прозрачный вариант разумнее рассматривать после того, как вы собрали исключения и стабилизировали правила.
Как перейти на Squid без остановки работы пользователей?
Самый безопасный сценарий — параллельный запуск: новый Squid обслуживает пилот или один филиал, а остальные остаются на старом решении. Это снижает риск простоя и дает живые кейсы для настройки ACL, исключений и таймаутов. Переключение «в один момент» стоит делать только когда конфигурация проста и откат занимает минуты.
Нужно ли включать кэширование в Squid и как не навредить?
Начните консервативно: кэшируйте только то, что точно статичное и не персональное, и сначала добейтесь стабильного доступа. Кэш обычно помогает на повторных загрузках обновлений, репозиториев и статических файлов, но может мешать личным кабинетам, банковским страницам и динамическим веб-приложениям. Если появляются жалобы на «устаревшие данные» или странные входы, первым делом отключайте кэш для проблемного домена или типа запросов.
Как правильно построить ACL, чтобы конфигурация не превратилась в хаос?
Делайте правила читаемыми: отдельно описывайте пользователей и группы, отдельно ресурсы, отдельно исключения, и не смешивайте смысл в одном месте. Рабочий подход — сначала разрешить базовые вещи (обновления, обязательные сервисы), затем разрешить бизнес-сервисы нужным группам, а в конце явно закрыть остальное. Каждое исключение лучше сопровождать причиной и владельцем, иначе со временем оно превращается в постоянную «дыру».
Какие логи обязательно собирать при переходе на Squid?
Минимально вам нужны access-логи для ответа на вопрос «кто, куда и когда», и системные логи Squid, чтобы видеть ошибки DNS, TLS, диска и перезапуски. Важно заранее договориться о формате полей и сроках хранения, чтобы по инциденту можно было сделать короткую выборку без ручных догадок. Доступ к логам тоже нужно ограничить, потому что там часто есть персональные данные и детали активности пользователей.
Когда TLS-инспекция в Squid уместна, а когда лучше не трогать?
Если нет отдельного согласования с ИБ и юридической частью, безопасный дефолт — не расшифровывать трафик и ограничиться метаданными, которые дает HTTPS. Инспекция уместна точечно и на управляемых устройствах, когда политика это разрешает и есть понятная цель (например, проверка конкретных категорий или сегментов). Банки, платежи, медицина, госресурсы и сервисы с пиннингом сертификатов часто лучше сразу выносить в исключения, чтобы не ломать бизнес-процессы.
Как организовать быстрый откат, если после переключения начались проблемы?
План отката должен быть практичным и быстрым: вы заранее знаете, что переключаете обратно (PAC/WPAD, политики, маршрут), кто это делает и как подтверждается восстановление. Хороший ориентир — вернуть трафик на старый прокси за 5–10 минут и иметь критерии «стало плохо», например резкий рост 407/403/5xx или массовые жалобы на конкретные критичные сервисы. Если откат долгий или «не проверяли», миграция становится рисковой даже при хорошей конфигурации.
