7 мин
Учет ИБ-инцидентов в промышленной сети: какие поля нужны
Учет ИБ-инцидентов в промышленной сети: какие поля фиксировать для связи с OT-активом, зоной и мерами реагирования, сохраняя конфиденциальность.
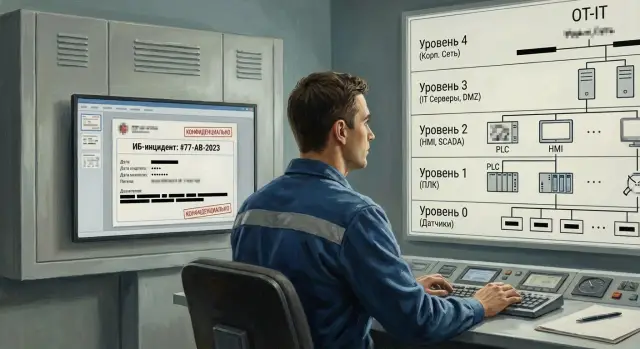
Задача: связать инцидент с реальным OT-контекстом
Учет ИБ-инцидентов в промышленной сети отличается от офисного тем, что цель - не просто убрать угрозу, а сохранить безопасную и непрерывную работу процесса. Один и тот же индикатор (например, подозрительный сетевой запрос) в IT часто означает «изолировать и переустановить», а в OT может означать «не трогать прямо сейчас, иначе остановим линию».
Если инцидент не привязан к конкретному OT-активу и зоне сети, расследование быстро буксует. Команда видит события в журнале, но не понимает, что это за узел: инженерная станция, HMI, сервер исторических данных, контроллер или тестовый ноутбук подрядчика. Без зоны тоже сложно: одно дело трафик внутри ячейки, другое - пересечение границы между IT и OT.
Есть и обратная сторона: часть данных нельзя писать в открытую, особенно если журнал доступен широкой группе. Обычно стараются не фиксировать в общей части:
- точные IP-адреса и имена хостов, если это раскрывает схему сегментации
- логины, персональные данные и имена сотрудников
- детали технологического процесса (рецептуры, параметры, названия установок)
- полные дампы конфигураций и ключевые файлы проектов контроллеров
Поэтому нужен единый формат карточки инцидента, где есть OT-смысл, но нет лишней конкретики. Он нужен сразу нескольким ролям: сменному персоналу (чтобы понимать риск для процесса), ИБ (чтобы вести расследование), инженерам АСУ ТП (чтобы оценить влияние на оборудование), руководителям (чтобы видеть статус и последствия). В проектах, где участвуют интеграторы и поставщики инфраструктуры (например, при разворачивании серверов и рабочих мест, как у GSE.kz), единый формат еще и снижает путаницу между командами: все обсуждают один и тот же инцидент одними и теми же полями.
Простой пример: SOC заметил подозрительный доступ по SMB. Если карточка сразу указывает «инженерная станция, зона: OT-DMZ, критичность: высокая, допустимое действие: только блокировка на межсетевом экране», команда не будет вслепую отключать узел и рисковать остановкой участка.
Как не нарушить конфиденциальность при ведении журнала
Журнал инцидентов в OT нужен, чтобы действовать быстро и повторять удачные решения, а не чтобы собирать все подряд. Практичное правило: фиксируйте только то, без чего нельзя принять решение, выполнить реагирование и подтвердить, что оно было сделано.
Хорошо работает разделение карточки на уровни доступа:
- Общая часть: то, что нужно большинству участников (краткое описание, время, статус, категория, затронутая зона и актив в виде идентификаторов).
- Ограниченная часть: детали, которые помогают расследованию, но могут раскрыть устройство сети или персональные данные.
- Секретная часть: сырые артефакты и «полная точность» (дампы трафика, конфигурации, точные имена узлов) - в отдельном защищенном хранилище, доступ по запросу.
Чтобы не писать лишнее, используйте псевдонимы вместо имен и адресов: Asset ID, Site ID, Zone ID, Case ID. Реальные соответствия (какой Asset ID - это какая станция, где она стоит, какой у нее IP) храните отдельно, с контролем доступа.
Обычно самый заметный эффект дают несколько простых практик:
- Ролевой доступ: SOC видит общую часть, OT-инженер - технические детали, руководитель - итоги и риски.
- Журналирование изменений: кто и когда менял поля, что именно изменилось, почему.
- Маскирование данных: не ФИО, а роль («дежурный электрик»), не полный IP, а подсеть или хеш.
- Контроль вложений: файлы и скриншоты только по необходимости, с пометкой уровня доступа.
- Шаблоны комментариев: чтобы люди не вставляли конфиги и пароли в свободный текст.
Пример: при подозрении на компрометацию инженерной станции вы записываете «Asset ID: ENG-042, Zone ID: OT-ENG, признак: запуск неизвестного процесса, влияние: остановки нет». Полное имя пользователя, имя хоста и точный путь к файлу остаются в закрытой части и выдаются только тем, кто реально работает с узлом.
Сроки хранения задайте по типам данных и риску. Метаданные карточки обычно хранят дольше ради аналитики, а сырые артефакты (пакеты, дампы, логи с персональными данными) - меньше и с автоматическим удалением, чтобы журнал не превращался в склад чувствительной информации.
Базовые поля карточки инцидента: что фиксировать всегда
Карточка должна быть одинаковой для всех случаев. Чем проще и стабильнее набор полей, тем легче находить связи между событиями, сравнивать похожие эпизоды и не спорить о формулировках.
1) Идентификация случая. Нужен уникальный идентификатор (Incident ID) и источник регистрации: кто завел запись и откуда пришел сигнал (дежурный инженер, мониторинг, подрядная организация). Это помогает оценивать надежность входной информации и не терять нить при передаче между командами.
2) Время. В OT оно критично из-за смен, технологических окон и плановых работ. Удобно разделять минимум четыре отметки: когда заметили, когда предположительно началось, когда подтвердили, когда завершили. Всегда указывайте часовой пояс.
3) Классификация. Достаточно понятного класса: вредоносное ПО, попытка несанкционированного доступа, нарушение политики, сбой или аномалия. Этот выбор влияет на то, кого подключать и какие процедуры запускать.
4) Критичность. Лучше задавать шкалой (низкая/средняя/высокая) и коротким критерием влияния: «влияние на доступность технологического сегмента», «риск для непрерывности производства», «затронуты учетные записи». В общей части не перечисляйте конкретные уязвимости, адреса и модели оборудования.
5) Короткое описание. Нейтральное и проверяемое: что заметили и где, без обвинений и без гипотез, выданных за факт.
Удобное правило для текста описания:
- только наблюдаемые признаки
- место в общих терминах (участок, зона, роль системы)
- статус (подтверждено или требует проверки)
- масштаб (один узел, группа, неизвестно)
- следующий шаг и ответственный
Пример: «Зафиксирована попытка входа в инженерный контур с нетипичной учетной записью. Подтверждение ожидается. Влияние на технологический процесс не выявлено. Назначен ответственный от ИБ и инженер смены для проверки».
Поля для привязки инцидента к OT-активу
Чтобы инцидент в OT не превращался в абстрактное «что-то случилось», карточка должна однозначно указывать, с каким активом связано событие. При этом журнал не должен превращаться в хранилище персональных и чувствительных техдеталей.
Минимальный набор идентификаторов
Опирайтесь на внутренние коды и роль актива в производстве. Это связывает инцидент с реальным контекстом и помогает сохранить конфиденциальность.
- Asset ID (внутренний): идентификатор из CMDB/реестра, который не раскрывает серийный номер.
- Тип актива: ПЛК, HMI, инженерная станция, сервер, шлюз, коммутатор (лучше из справочника).
- Роль в процессе: управление, визуализация, архив/историк, инженерное обслуживание, межсетевой обмен.
- Владелец и ответственный по роли: например «АСУ ТП цеха 3», «дежурный инженер смены» (без ФИО).
- Критичность актива: влияние на безопасность, качество, простой (например, шкала 1-4 или S/Q/D).
Этих полей обычно достаточно, чтобы строить отчеты по «горячим» активам, не раскрывая лишнее.
Технические данные без лишней детализации
Технические атрибуты полезны для расследования, но в общей части лучше хранить их как диапазоны или классы. Например: семейство ОС и класс версии («Windows 10 LTSC, версия 20xx»), класс прошивки ПЛК («v3.x»), группа модели («серия S200»). Точные номера сборок, серийники, MAC-адреса и полные конфиги - только в закрытых вложениях с ограниченным доступом.
Пример: срабатывает правило на подозрительный запуск утилиты на инженерной станции. В карточке фиксируют Asset ID, тип «инженерная станция», роль «обслуживание ПЛК», критичность «высокая по простою», владельца «служба АСУ ТП». Этого хватает, чтобы быстро связать инцидент с конкретным участком и назначить правильную команду, не публикуя точные версии ПО и серийные номера.
Поля для привязки к зоне сети и сегментации
Привязка к сетевой зоне и границам сегментации показывает, где возникла проблема, куда она могла распространиться и какие точки контроля стоит проверить.
Минимальный набор полей по зоне
Начните с однозначных кодов и справочников, а не с «как называют на смене».
- Zone ID и имя зоны: например «OT-Z03, участок розлива, ячейка 2».
- Класс зоны по ISA-95/IEC 62443: уровень (L2/L3) или тип зоны (Control Zone, DMZ и т.п.).
- Затронутые сегменты (коды): VLAN-идентификаторы, подсети, контуры - в виде «VLAN-120, NET-10.20.30.0/24».
- Точки пересечения зон (по ID): межсетевой экран FW-07, шлюз GW-03, jump-сервер JS-02.
- Направление и тип связи: внутри зоны, между зонами, в DMZ; «инициатор -> получатель», плюс протокол верхнего уровня (например, RDP, SMB) без полного дампа.
Как фиксировать границы, не раскрывая лишнее
Разделяйте «что записываем в карточку» и «что лежит в доказательствах». В карточке оставляйте коды сегментов и ID точек контроля. Полные IP, имена хостов, правила FW и конкретные лог-строки храните отдельно, с доступом по ролям.
Пример: замечен подозрительный вход на инженерную станцию. В карточке указывают OT-Z03, затронутые VLAN-120 и DMZ-VLAN-10, пересечение через JS-02 и FW-07, направление DMZ -> OT. Уже понятно, какие журналы запрашивать и где искать первопричину.
Доказательства и наблюдения: как фиксировать без лишних деталей
В OT важно записывать наблюдения так, чтобы их можно было проверить и связать с контекстом, но не разносить по журналу чувствительные данные (учетные записи, точные адреса, детали техпроцесса).
Что писать в открытой части карточки
Опишите сигнал простыми словами и укажите источник: алерт средства защиты, запись лога, сообщение инженера, отклонение процесса по коду/тегу (без раскрытия рецептур и параметров). Дальше фиксируйте только проверяемые факты и отдельно помечайте предположения.
В большинстве случаев хватает пяти пунктов:
- источник сигнала и время (в едином часовом поясе)
- суть наблюдения (что именно «не так»)
- уверенность (подтверждено / вероятно / требует проверки)
- влияние (простой, качество, безопасность) и уровень критичности
- предполагаемый вектор (USB, удаленный доступ, подрядчик, другое)
Что убирать в закрытые поля
Артефакты храните «точно», но не публично: хеши файлов, полные имена и пути, IP и MAC, конкретные учетные записи, серийные номера, точные названия проектов на инженерной станции. В общей части оставляйте обезличенный идентификатор («учетка-3», «хост-7») и внутренний номер артефакта.
Пример: инженер сообщил, что на инженерной станции появился новый исполняемый файл, после чего станция стала медленно реагировать. В карточке фиксируете факт появления, время и влияние (риск остановки работ). В закрытые поля - хеш, полный путь, учетку, под которой запускалось, и список адресов, куда шли попытки соединения.
Поля мер реагирования и управления действиями
В OT важно фиксировать не только сам факт инцидента, но и каждое действие в ответ. По записи должно быть понятно: что изменили, кто разрешил, чем рисковали и как вернули систему в норму. Персональные данные лучше не хранить - обычно достаточно роли и внутренних идентификаторов.
Статус и ход работ
Статусы держите простыми и одинаковыми: новый, в работе, сдержан, устранен, закрыт, отложен. Полезно добавлять время и короткую причину (1-2 слова), чтобы разбирать задержки.
Блок «действия»
Каждое действие - отдельная строка с результатом. Типовые меры в промышленной сети повторяются: изоляция узла, блокировка учетной записи, изменение правил на межсетевом экране, отключение удаленного доступа, откат конфигурации.
Минимальный набор полей для каждой меры:
- тип меры (изоляция, блокировка, изменение правил, восстановление)
- объект (ID актива, ID учетной записи, ID правила)
- время начала и окончания
- исполнитель (роль/команда) и одобрение (роль) + время
- результат (успешно, частично, откат) и короткий комментарий
В OT обязательно добавляйте поле «риск от меры»: что может остановиться прямо сейчас. Записывайте ожидаемое влияние на процесс («возможна потеря телеметрии», «остановка линии N», «переход в ручной режим») и заранее согласованный обходной путь («локальное управление», «резервный канал», «работа по регламентам»).
Чтобы меры были управляемыми, привязывайте их к процессам изменений и восстановления: ID заявки на изменение, ID заявки на восстановление, ID аварийного окна. Это помогает доказать санкционирование и быстро найти план отката.
Пример: триаж показал подозрительную активность на инженерной станции. Статус - «в работе». Решают сначала «сдержать» без остановки производства: ограничивают соединения станции до нужных сервисов, фиксируют одобрение от роли «дежурный инженер АСУ ТП», описывают риск (возможна задержка обновления проектов) и обходной путь (перенос работ на резервную станцию). После проверки и очистки статус меняют на «устранен», привязывают ID восстановления (переустановка образа) и закрывают после согласованного времени мониторинга.
Простой процесс расследования: шаги от триажа до закрытия
В OT важно расследовать быстро, но аккуратно. Ошибка в реагировании может остановить технологический процесс, поэтому процесс должен быть коротким и одинаковым для всех смен.
Шаги, которые проходят почти все OT-инциденты
-
Триаж и владелец. Подтвердите, что это инцидент, а не плановые работы. Назначьте владельца (SOC, ИБ-дежурный или инженер АСУ ТП) и время следующего обновления статуса.
-
Сдерживание с минимальным вмешательством. Выбирайте самое мягкое действие, которое снижает риск: запрет удаленного доступа, временная блокировка учетной записи, перевод узла в ограниченный VLAN. Резкое отключение - только если это согласовано и не создает больший риск.
-
Сбор фактов. Зафиксируйте: ID OT-актива, роль (инженерная станция, PLC, HMI), зона и сегмент сети, затронутые протоколы, доступные логи (EDR, домен, коммутаторы, журнал изменений). Если есть персональные данные, используйте служебные идентификаторы и храните детали отдельно.
-
Анализ причины. Восстановите цепочку: откуда пришло воздействие, какие учетные записи использовались, какие настройки менялись, были ли попытки закрепления. В OT часто всплывают удаленный доступ подрядчика, общие пароли, перенос файлов через USB.
-
Устранение, восстановление и закрытие. Уберите причину (пароль, правило доступа, уязвимый сервис), проверьте работоспособность участка и настройте контроль повторов (алерт, проверка конфигурации). При закрытии зафиксируйте итог, уроки, задачи, сроки и ответственных.
Пример: срабатывает алерт на инженерной станции в зоне управления. Сдерживание: временно запретить RDP извне зоны и сменить пароль учетной записи, не выключая станцию. Факты: время, хост-ID, зона, список подключений, последние изменения проекта. Урок: запрет общих учетных записей и отдельный регламент для подрядчиков с журналированием удаленных сессий.
Пример сценария: инцидент вокруг инженерной станции в OT
На участке АСУ ТП диспетчер замечает всплеск запросов к ПЛК со стороны инженерной станции (ES-17). Запросы идут в той же зоне, где обычно выполняют настройку, но время нетипичное: поздно вечером, вне окна работ. Параллельно на коммутаторе фиксируются краткие попытки связи с соседней зоной через разрешенный сервис.
Карточку инцидента заводят сразу, чтобы учет не распался на устные договоренности. Заполняют только то, что связывает событие с OT-контекстом, без лишней конкретики.
Минимальный набор полей может выглядеть так:
- Incident ID: OT-2026-014
- Время обнаружения/период: 21:42-22:05
- Asset ID (инженерная станция): ES-17
- Связанный OT-актив: PLC-3A (ID из реестра)
- Zone ID: OT-Z3 (ячейка/линия), плюс отметка о соседней зоне OT-Z2
- Критичность: высокая (риск влияния на технологический процесс)
Сначала проверяют самое частое и «мирное» объяснение: были ли легитимные работы. Запрашивают у производства журнал изменений и заявки на обслуживание, а у ИТ-ИБ - список последних входов на инженерную станцию. Отдельно уточняют факт доступа подрядчика: было окно или нет, и как именно (локально/удаленно), без персональных данных в карточке.
Пока идет проверка, делают мягкое сдерживание. Временно ужесточают правило межзонного трафика: оставляют только нужные сервисы для технологического обмена, а конфигурационные протоколы разрешают только в утвержденное окно и только от ES-17. В карточке фиксируют действие, время, ответственного по роли и основание.
Итог расследования: подтверждается, что подрядчик выполнял диагностику, но использовал устаревший профиль доступа. Из-за этого инженерная станция начала опрашивать ПЛК по неверному шаблону. Восстанавливают исходные настройки, обновляют профиль и проверяют целостность конфигураций.
Уроки лучше записывать коротко и в форме действий:
- привязывать доступ подрядчика к конкретному Zone ID и времени
- хранить шаблоны правил сдерживания как готовые плейбуки
- после работ запускать короткую валидацию: кто с чем общается, нет ли лишних запросов
Частые ошибки в учете OT-инцидентов
Чаще всего карточка превращается либо в «роман» с лишними деталями, либо в пару строк, по которым ничего не восстановить. Нужен баланс: достаточно OT-контекста для расследования и аудита, но без раскрытия чувствительных данных.
Смешивают персональные данные и техданные в одном поле. В описании пишут и события на станции, и ФИО оператора, и контакты смены. В итоге карточку нельзя безопасно показывать подрядчику, SOC или коллегам из другого цеха. Разделяйте: общая техническая часть и закрытая часть с ПДн.
Нет стабильных ID для активов и зон. Когда все пишется текстом («ПЛК на линии 3», «сеть цеха»), появляются дубликаты и разночтения. Минимум: единый идентификатор OT-актива (из реестра), идентификатор зоны/сегмента и неизменяемое правило именования.
Слишком много деталей в открытой части. IP-адреса, версии прошивок, имена хостов, учетные записи, пути к проектам повышают риск утечки. Безопаснее держать это в закрытых вложениях или заменять псевдонимами.
Не фиксируют решения и одобрения. Записали «отключили порт», но не указали почему выбрали именно эту меру, какие риски принимали и кто одобрил. Потом сложно объяснять остановку участка и повторять удачную тактику.
Закрывают инцидент без уроков и задач. Если нет короткого вывода (корневая причина) и конкретных задач (что поменять в сегментации, доступах, резервном копировании, мониторинге), инцидент возвращается. Полезная привычка: закрытие допускается только когда есть 1-3 измеримых действия и ответственные.
Небольшой пример
В журнале зафиксировали: «Вирус на инженерной станции, устранили». Через месяц повторилось, потому что не записали ни ID станции, ни зону, ни решение (почему оставили общий доступ), ни задачу (разделить доступ к проектам и обновить белые списки). Нормальная карточка показывает: какой актив, где, какая мера была согласована, и что нужно изменить, чтобы это не стало регулярной аварией.
Быстрый чеклист и следующие шаги внедрения
Если единого журнала еще нет, начните с малого: один шаблон карточки и одно место хранения. Цель простая: карточка должна связывать событие с OT-контекстом (актив, зона, влияние) и не раскрывать лишние детали.
Минимальный чеклист полей, который обычно дает 80% пользы:
- ID инцидента и время: уникальный номер, время обнаружения, время начала (если известно), кто сообщил.
- Привязка к OT: Asset ID, тип актива (PLC/HMI/инженерная станция/сервер), владелец актива (подразделение).
- Сеть и зона: Zone ID, сегмент (например, Level 2/3), путь связи (межзонный канал, шлюз), критичность зоны.
- Влияние и риск: затронутый процесс, уровень влияния (безопасность людей, качество, простои), масштаб.
- Статус и меры: стадия (триаж, расследование, сдерживание, восстановление, закрыт), принятые меры, ответственные по ролям, сроки.
Для конфиденциальности держите минимум два уровня: общие поля для большинства участников и закрытые поля для узкого круга. В закрытую часть обычно уходят имена пользователей, конкретные IP/серийные номера, полные логи и детали уязвимостей.
Для контроля качества учета часто хватает трех отчетов: по зонам (где чаще), по активам (какие устройства повторяются), по причинам и мерам (что реально снижает повторяемость).
Следующие шаги, чтобы закрепить процесс:
- выберите один шаблон карточки и пилот на 1-2 зонах
- назначьте роли: кто заводит инцидент, кто утверждает закрытие, кто владеет активом
- введите еженедельный разбор на 30 минут: несколько инцидентов, 1-2 урока, одно действие в план
- настройте права доступа и хранение: журнал, вложения, сроки хранения, аудит изменений
Если журнал и связанные артефакты нужно разместить на устойчивой инфраструктуре и закрепить поддержку, это часто делают вместе с системным интегратором. В Казахстане такие задачи, включая серверную инфраструктуру и сопровождение, выполняет GSE.kz как производитель и системный интегратор с линейкой серверов S200 Series и круглосуточной технической поддержкой.
Частые вопросы
Чем учет ИБ-инцидентов в OT отличается от IT на практике?
Главная разница в цели: в OT вы в первую очередь защищаете безопасность и непрерывность процесса, а не «чистоту» ИТ-среды. Поэтому в карточке инцидента всегда фиксируйте влияние на производство и допустимые действия, чтобы никто не отключил критичный узел без согласования.
Какие поля в карточке инцидента нужно заполнять всегда, даже в спешке?
Начните с минимального ядра: Incident ID, время (обнаружено/началось/подтверждено/завершено), Asset ID и тип актива, Zone ID, краткое наблюдаемое описание, критичность по влиянию на процесс, текущий статус и первое согласованное действие. Если этих полей нет, расследование обычно разваливается на устные договоренности.
Как правильно привязать инцидент к конкретному OT-активу, не раскрывая лишнее?
Используйте внутренние идентификаторы и роль в процессе: Asset ID из реестра, тип (PLC/HMI/инженерная станция/сервер), роль (управление/визуализация/историк/обслуживание), владелец по подразделению и критичность актива. Реальные IP, имена хостов и серийные номера держите в закрытой части или в отдельном хранилище сопоставлений.
Какие данные по сетевой зоне важнее всего для карточки инцидента?
Фиксируйте Zone ID, класс зоны (например, уровень L2/L3 или DMZ), а также точки пересечения по ID (FW, шлюз, jump-сервер) и направление связи. Это дает контекст «где произошло и через что могло пойти дальше», без публикации полной схемы адресации и правил фильтрации.
Как вести журнал инцидентов и не нарушать конфиденциальность сети и персональных данных?
Разделите карточку на уровни доступа: в общей части оставьте только то, что нужно для принятия решений, а точные адреса, учетные записи и сырые артефакты перенесите в закрытую часть. В общей части используйте псевдонимы (Asset ID, Zone ID, Case ID), а соответствия храните отдельно с контролем доступа.
Что именно писать в описании инцидента, чтобы оно было полезным и проверяемым?
Записывайте наблюдаемые факты и источник сигнала, а гипотезы помечайте отдельно как неподтвержденные. Обычно достаточно указать время, что именно обнаружено, уровень уверенности и влияние на процесс; подробные лог-строки, пути к файлам и полные дампы лучше хранить как артефакты с ограниченным доступом.
Как документировать меры реагирования в OT, чтобы потом не спорить «кто разрешил и чем рисковали»?
Каждое действие фиксируйте как отдельную запись: что сделали, к чему применили (ID актива/учетки/правила), когда, кем по роли и кто одобрил, плюс результат. Обязательное OT-поле — риск от меры: что может остановиться или ухудшиться прямо сейчас и какой согласован обходной путь.
Что делать, если SOC предлагает «изолировать и переустановить», а OT боится остановки линии?
Начните с проверки легитимных работ и мягкого сдерживания, которое не останавливает участок: ограничение межзонного доступа, блокировка удаленного входа, перевод в более строгий режим доступа. Полное отключение узла выбирайте только при явной угрозе и после согласования с ответственными за процесс.
Как выглядит простой процесс расследования OT-инцидента от триажа до закрытия?
Достаточно короткого, одинакового для смен маршрута: триаж и назначение владельца, мягкое сдерживание, сбор фактов (Asset ID, Zone ID, протоколы, доступные логи), анализ причины, восстановление и контроль повторов, затем закрытие с 1–3 конкретными задачами. Время следующего обновления статуса лучше задавать сразу, чтобы инцидент не «завис» между командами.
Как организовать инфраструктуру и поддержку для журнала инцидентов, если участвует интегратор (например, GSE.kz)?
Планируйте место хранения и права доступа так, чтобы журнал и артефакты жили на устойчивой инфраструктуре с понятной поддержкой и аудитом изменений. Если это делается совместно с интегратором, заранее согласуйте формат идентификаторов (Asset ID/Zone ID), роли доступа и сроки хранения, чтобы SOC, OT-инженеры и руководство работали по одному шаблону без разночтений.
