8 мин
Capture-платформа для потокового сканирования: как сравнить
Как выбрать capture-платформа для потокового сканирования: сравнение Kofax, ABBYY FlexiCapture и Ephesoft по классификации, полям, валидации и интеграциям с СЭД.
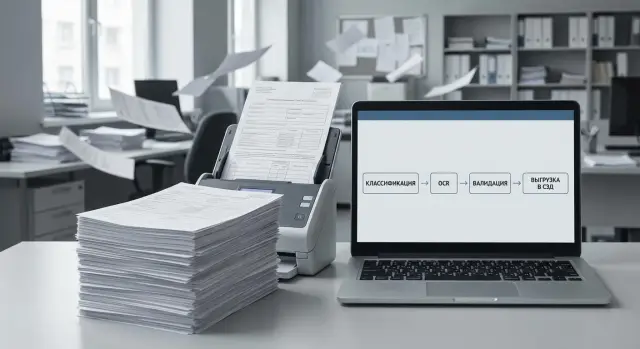
Задача потокового ввода документов простыми словами
Потоковый ввод документов - это когда в организацию каждый день приходят десятки или тысячи страниц: счета, договоры, заявления, накладные, письма, медкарты, анкеты. Их нужно быстро превратить в данные и разложить по нужным папкам и карточкам, а не хранить стопкой сканов.
Обычно болит сразу несколько вещей: документов много и они разные, сотрудники тратят время на ручной ввод, а ошибки в реквизитах (номер, дата, ИИН/БИН, сумма, контрагент) потом всплывают в бухгалтерии, закупках или архиве. Даже при хорошем скане без контроля на этапе ввода ошибка легко проходит дальше.
Capture-платформа для потокового сканирования отличается от простого OCR. OCR отвечает на вопрос: «что написано на картинке». Capture отвечает на более практичные вопросы: «что это за документ», «где в нем нужные поля», «можно ли доверять распознаванию» и «куда отправить результат».
Процесс удобно представлять как конвейер:
- сканирование создает файлы (PDF/TIFF) и базовые метаданные;
- capture классифицирует документ и извлекает поля;
- валидация ловит сомнительные места и просит проверить;
- интеграция отправляет в СЭД/архив и в бизнес-системы.
Здесь важно понимать границу: capture - это входной «конвейер». Управление документами (СЭД/архив) начинается там, где есть карточка, маршруты согласования, хранение, права доступа и поиск.
Сравнение по прайсу или красивому демо часто обманывает. На демо показывают один идеально подготовленный шаблон. В реальности у одного «счета» может быть 20 вариантов, печати закрывают текст, а часть файлов приходит с телефона. Поэтому сравнивать стоит на своих документах и по тому, сколько ручной работы останется после запуска.
Собираем требования перед сравнением платформ
Сравнивать Kofax, ABBYY FlexiCapture и Ephesoft имеет смысл только после того, как вы зафиксировали, что именно будет попадать в систему и какой результат вы ждете на выходе. Иначе обсуждение быстро сведется к списку функций, которые в реальном потоке могут не понадобиться.
Начните с входного потока документов. Разные типы ведут себя по-разному: счета и акты обычно более структурированы, а договоры, письма и заявления часто приходят в свободном виде и с разным качеством печати. Отдельно отметьте рукописные поля, печати, подписи, приложения на нескольких листах и смешанные пачки.
Дальше посчитайте объемы и «грязь» потока. Важно не только среднее число страниц в день, но и пики (например, в конце месяца), а также доля плохих сканов: перекос, бледная печать, тени от скрепок, сканы с телефона. Это напрямую влияет на скорость операторов, точность OCR и объем ручной проверки.
Чтобы требования были проверяемыми, зафиксируйте короткий набор критериев: какие документы в приоритете и какие поля обязательны; сколько страниц и пакетов в день и какой максимальный пик; через сколько минут или часов данные должны попасть в СЭД; где можно размещать систему (on-prem, в вашем дата-центре, в изолированном контуре); какие роли нужны (оператор, контролер/валидация, администратор).
Пример: если входящая почта должна попадать в СЭД в течение 30 минут после сканирования, а часть документов приходит «кривыми» сканами, вам понадобится не только хорошее распознавание, но и понятный процесс очередей, валидации и контроля SLA. Без этого сравнение платформ будет нечестным: вы не сможете одинаково проверить их на реальной нагрузке.
Сравниваем классификацию документов (Kofax, ABBYY, Ephesoft)
Классификация отвечает на простой вопрос: что это за документ и куда его дальше отправить. Важно, чтобы определение типа работало стабильно в реальном потоке, а не только на аккуратных примерах.
Обычно у всех трех вендоров есть три подхода, которые можно комбинировать: правила (по ключевым словам, структуре, расположению блоков), шаблоны (фиксированная верстка) и машинное обучение (когда макеты меняются или типов много). На практике сравнивают не «у кого ML лучше», а сколько усилий нужно, чтобы довести качество до нужного уровня и поддерживать его дальше.
Отдельно проверьте «пакетную логику»: баркоды и QR для идентификации, листы-разделители, а также то, как платформа режет поток на документы и определяет границы. Это критично, если оператор сканирует пачку «как есть».
Смешанные пачки - частый тест. Например, входящая почта: договор, счет, акт и письмо в одном пакете, плюс приложения. Попросите показать, как Kofax, ABBYY FlexiCapture и Ephesoft ведут себя на похожих документах (две формы одного счета) и на плохом качестве сканов.
Для сопровождения классификаторов важно понять, кто будет «учить» систему и как это устроено: бизнес-пользователь, аналитик или команда интегратора. На пилоте фиксируйте метрики: точность по каждому типу, долю документов, ушедших на ручную разборку, причины ошибок (плохой скан, похожие шаблоны, неверные границы), а также время на настройку и переобучение после изменения формы.
Извлечение полей: что проверять в OCR и разметке
При сравнении capture-платформы не начинайте с «у кого лучше OCR в целом». Начинайте с ваших полей и ваших документов. Один и тот же движок может отлично читать печатный текст, но ошибаться на штампах, таблицах или полях «в углу» на многостраничных формах.
OCR: язык, качество скана и «грязные» места
Проверьте качество распознавания на реальных сканах: копии, факсы, переснятые документы, разный DPI и контраст. Для Казахстана часто критичен русский язык, а иногда и казахский (включая смешанные бланки, где часть полей на казахском).
Отдельно прогоните кейсы, которые обычно ломают извлечение: наклоненный скан, тень от сгиба, штампы поверх текста, печати, подписи. Важно не только «видит ли текст», но и сохраняет ли платформа правильные символы (например, 0/О, 1/І), потому что это напрямую бьет по реквизитам.
Разметка и логика извлечения: не только «слово в слово»
Сравнивайте, как платформа извлекает таблицы (строки, итоги, переносы на следующую страницу), многостраничные формы (поле на 1-й странице, продолжение на 2-й), ключевые реквизиты (ИИН/БИН, номера счетов, даты, суммы), а также варианты одного и того же документа (старый и новый шаблон). Если у вас есть справочники, проверьте сценарии извлечения с валидацией «поле против справочника» (например, БИН по базе контрагентов).
Хороший признак - когда извлечение опирается не только на «координаты», но и на правила: регулярные выражения, контрольные длины, допустимые диапазоны дат и контекст (например, «БИН» рядом с числом).
Отдельный пункт - порог уверенности (confidence). Настройка должна быть гибкой: что отправлять на ручную проверку, а что пропускать автоматически. На пилоте полезно сразу измерять два числа: долю полей, ушедших в проверку, и долю ошибок, прошедших «мимо». Например, если из 10 000 счетов 30% полей постоянно требуют оператора, это будет стоить дороже, чем разница в лицензиях.
Валидация и контроль качества данных
Распознавание и извлечение полей дают результат только тогда, когда данные проходят понятную проверку. В capture-платформе валидация решает две задачи: не пропустить очевидные ошибки и быстро обработать спорные случаи, не останавливая поток.
Какие проверки стоит закладывать сразу
Начните с простых правил, которые ловят большую часть проблем еще до ручной проверки. Чем точнее правила, тем меньше «шумных» исключений у операторов.
Обычно в базовый набор входят проверки формата и длины (ИИН, БИН, номер договора, счет-фактура, даты), логики (дата не в будущем, сумма больше нуля, НДС соответствует ставке), обязательности критичных полей и зависимостей между полями (валюта и сумма, контрагент и БИН, серия и номер). Если для номера есть контрольная сумма, проверьте, поддерживается ли такая проверка.
Отдельный слой - сверка с внешними источниками: справочники контрагентов, база клиентов, ERP или кадровая система. Практичный критерий сравнения Kofax, ABBYY FlexiCapture и Ephesoft здесь простой: насколько легко настроить проверку «поле против справочника», и что происходит при несовпадении (подсказка, автозамена, запрет прохождения).
Исключения, роли и аудит
Ошибки должны попадать не в «общую очередь», а к нужным людям. Оператор исправляет опечатку в дате, бухгалтер подтверждает сумму, юрист решает спор по типу договора. Важно, чтобы платформа хранила журнал: кто менял поле, когда и по какой причине (комментарий или причина из списка). Это упрощает разбор инцидентов и внутренние проверки.
Для контроля качества полезна короткая отчетность: доля документов, ушедших на ручную проверку, топ причин ошибок и список шаблонов или типов документов, которые «сыпятся» чаще всего. Если в филиалах системно путают формат номера накладной, проще обновить правило и провести короткое обучение, чем бесконечно исправлять руками.
Интеграции с СЭД и архивом: на что смотреть
Если платформа хорошо распознает документы, но «не дружит» с вашей СЭД и архивом, пользователи все равно будут вручную переносить файлы и поля. Поэтому интеграции стоит проверять так же внимательно, как OCR.
Сначала уточните, как платформа доставляет результат в целевую систему: прямой API, готовые коннекторы к популярным СЭД, обмен через очередь сообщений или экспорт в папки (файлы плюс метаданные). Чем больше у вас поток и требований к контролю, тем хуже подходит вариант «просто выгрузка файлов».
Метаданные, структура и маппинг
Важно, чтобы в СЭД попадал не только PDF, но и правильная карточка документа: тип, номер, дата, контрагент, подразделение, сумма, а также вложения и версии.
Проверьте, поддерживаются ли: создание карточки и прикрепление файлов одним действием; передача нескольких документов в одном пакете (например, письмо плюс приложения); версионность (перезагрузка исправленного файла без потери истории); централизованное хранение правил сопоставления полей (маппинга); журналирование, чтобы было видно, что отправили, что не прошло и почему.
Отдельный вопрос - где живет логика маппинга и кто ее будет менять. Если правила «зашиты» в проект у интегратора, любые новые поля станут дорогими. Практичнее, когда часть настроек доступна администратору на стороне заказчика.
Маршруты и архивные требования
Если СЭД запускает процессы (регистрация, присвоение номера, резолюции, согласование, подписи), уточните, может ли интеграция стартовать нужный маршрут и вернуть статус обратно в capture для контроля качества.
Для архива проверьте форматы (часто нужен PDF/A), штампы и служебные отметки, индексирование и сроки хранения. Простой пример: бухгалтерия сканирует счета и акты, система должна сохранить PDF/A, проставить штамп «Скан-копия», заполнить индексы и уложить документ в нужный срок хранения без ручных шагов.
Если планируете внедрение «под ключ», системный интегратор (например, GSE.kz) обычно закрывает выбор способа обмена, настройку маппинга и проверку архивных форматов уже на пилоте.
Производительность, масштабирование и эксплуатация
Важно смотреть не только на качество распознавания, но и на то, как система ведет себя под реальной нагрузкой. Поток может быть спокойным на пилоте и неожиданно «встать» в конце месяца, когда бухгалтерия и канцелярия загружают все сразу.
Производительность оценивайте в своих единицах: не «страниц в минуту» из буклета, а сколько документов проходит путь от сканера до выгрузки в СЭД за час. Проверьте параллельную обработку (сколько потоков реально работает одновременно), наличие очередей и приоритетов (например, договоры быстрее актов), а также узкие места: распознавание, валидация, экспорт, сеть.
Масштабирование обычно упирается в то, можно ли добавлять узлы обработки и разделять роли. Удобнее, когда скан-станции, серверы распознавания и серверы экспорта можно разнести по нескольким серверам, а нагрузку распределять без остановки сервиса.
Отказоустойчивость лучше проверять практикой: что будет, если у скан-станции пропадет сеть или упадет один узел обработки. Хороший признак - задания не теряются, остаются в очереди и продолжаются после восстановления, а оператору видно, где произошел сбой.
При сравнении лицензирования задайте прямые вопросы: за что платите (страницы, пользователи, модули, серверные роли), как считаются пики и что с перерасходом, сколько стоит добавление узла и тестовой среды, включены ли обновления и поддержка.
Эксплуатация часто решает судьбу проекта. Нужны мониторинг очередей и ошибок, понятные логи, плановые обновления без «сюрпризов» и регулярное резервное копирование конфигураций, правил и обученных моделей. В организациях с распределенной сетью и 24/7 поддержкой заранее продумайте, кто и как будет дежурить по инцидентам, чтобы простой сканирования не остановил весь документооборот.
Безопасность и требования к инфраструктуре
Безопасность начинается с простого вопроса: где физически лежат изображения документов и извлеченные данные, и кто к ним имеет доступ. Уточните, поддерживается ли шифрование на диске и при передаче между компонентами, а также можно ли отдельно защищать временные папки, кэш и базы, где хранятся результаты OCR.
Хороший признак - когда права доступа можно настроить по ролям и не держать всех пользователей «админами». На практике полезна четкая сегрегация: оператор сканирует и видит минимум данных, валидатор подтверждает спорные поля, администратор управляет настройками, а аудит просматривает историю действий.
Проверьте, какие журналы ведет система: входы, изменения правил, ручные правки полей, экспорт в СЭД, ошибки распознавания. Важно, чтобы логи совпадали с внутренними регламентами (срок хранения, неизменяемость, доступ по запросу службы безопасности).
Перед выбором поставщика уточните поддержку: как долго поддерживаются версии, как быстро выходят патчи, что происходит при обнаружении уязвимости и можно ли обновляться без остановки критичных потоков.
По инфраструктуре заранее всплывают вопросы про пики пользователей и объем страниц, типы файлов (сканы, PDF, фото), узкие места (CPU для OCR, RAM для очередей, диск для образов), требования к диску (скорость, резервирование, объем под ретеншн), а также нужен ли GPU (обычно только для отдельных моделей и задач).
Если обработка должна идти внутри периметра, проверьте совместимость с корпоративными серверами и политиками. В проектах с повышенными требованиями к контролю и прозрачности поставок часто выбирают развертывание на собственных мощностях - в том числе на серверах, которые можно закупить и обслуживать локально.
Пошаговый подход к сравнению и пилоту
Сравнение платформ по презентациям почти ничего не дает: у всех будет «OCR, классификация и валидация». Рабочая картина появляется только на ваших документах и правилах.
Шаг 1: подготовьте тестовый набор
Соберите 200-500 документов из реального потока. Добавьте «неудобные» случаи: перекосы и бледная печать, штампы и подписи, разные шаблоны одного типа, сканы с телефона, дубликаты, многостраничные пакеты.
Заранее опишите 3-5 сценариев, которые платформа должна закрыть: распознавание типа документа, извлечение ключевых полей и выгрузка в СЭД или архив с нужными атрибутами.
Шаг 2: договоритесь о метриках и правилах подсчета
Чтобы спор не превратился в «мне кажется», зафиксируйте, как вы меряете результат: точность по типам документов и долю «не распознано»; долю полей, ушедших на ручную правку; среднее время обработки на документ (включая валидацию); процент «сквозной обработки» без участия оператора; причины ошибок (качество скана, шаблон, правило, интеграция).
Шаг 3: сделайте матрицу оценки и проведите пилот
Сведите оценки в таблицу: функционал (классификация, извлечение, валидация), интеграции с вашей СЭД/архивом, удобство настройки, сопровождение, требования к инфраструктуре и стоимость владения.
Пилот обычно занимает 2-4 недели. Ведите журнал ошибок и доработок: что исправляется настройками, что требует изменения процесса, а что упрется в интеграцию.
Если пилот затрагивает железо и инфраструктуру (сканеры, серверы, рабочие места операторов), полезно подключить системного интегратора заранее. Например, GSE.kz часто помогает связать требования к потоку документов с реальными ограничениями по оборудованию и поддержке.
Пример сценария: поток документов для организации с СЭД
Представьте канцелярию крупной организации, где каждый день приходит входящая корреспонденция, счета и договоры. Документы приносят пачками, условно по 2000 страниц за смену: часть на хорошем бланке, часть копии с печатями, часть вообще фото или факсы. Задача простая по смыслу: быстро завести документы в СЭД так, чтобы по ним можно было искать, согласовывать и хранить в архиве.
Типовой поток обработки выглядит так: сканирование пачки в единый поток и автоматическое разделение на документы; классификация (письмо, счет, договор и подтипы при необходимости); извлечение полей (номер, дата, контрагент, ИИН/БИН, сумма, валюта, номер договора); проверка оператором только спорных мест; передача в СЭД (создание карточки, прикрепление PDF, заполнение метаданных).
Исключения начинаются сразу. Плохие сканы дают ошибки OCR, нестандартные формы не попадают в шаблон, встречаются дубли (один и тот же счет в двух конвертах), а пустые страницы могут «разорвать» документ на две части. Поэтому в пилоте заранее договоритесь, что система делает сама, а что уходит в ручную очередь: например, все «сомнительные» суммы и даты всегда проверяются человеком.
На этом примере удобно сравнивать Kofax, ABBYY FlexiCapture и Ephesoft по одинаковым критериям, а не по спискам функций в презентации. Смотрите, как уверенно платформа разделяет пачку и классифицирует документы без долгой настройки, насколько точно извлекаются ключевые поля и как быстро правятся правила при изменении формы, насколько удобна валидация (экран, подсветка ошибок, выборочная проверка), как устроена интеграция с СЭД и архивом (очереди, повторная отправка при сбоях), и есть ли контроль дублей и понятная статистика по проблемным полям.
Если у вас уже есть СЭД, попросите на пилоте показать полный путь одного документа: от сканера до карточки в СЭД и записи в архив. Именно здесь всплывают реальные ограничения и стоимость сопровождения.
Типовые ошибки при выборе capture-платформы
Самая частая ошибка - выбирать платформу по эффектному демо. На демо обычно идеальные сканы и заранее настроенные правила. В реальности будут кривые печати, разные версии бланков, рукописные пометки и «похожие» документы, которые путаются между собой.
Вторая проблема - недооценка того, сколько стоит жить с настройками. Шаблоны, правила классификации, словари, исключения и проверки данных нужно поддерживать: менять при обновлении форм, добавлять поля, разбирать новые типы ошибок. Если это не заложить в план, проект быстро превращается в бесконечные правки.
Часто «ломается» и интеграция с СЭД или архивом. Дело не только в коннекторе, а в деталях: сопоставление полей, правила именования, очереди на отправку, повторная отправка при сбое, контроль дублей, журналирование. Если этого нет, операторы начинают вручную «допинывать» документы, и эффект автоматизации пропадает.
Еще одна ловушка - пытаться автоматизировать 100% с первого дня. Практичнее начать с самых массовых и стабильных типов документов, а сложные случаи отправлять на валидацию.
Проверьте, не допускаете ли вы эти промахи: тестируете на «лучших» примерах вместо реальной выборки с ошибками; не считаете трудозатраты на поддержку правил и шаблонов; не проговариваете сценарии ошибок интеграции и повторной доставки; закладываете нулевую долю ручной проверки с самого старта; не планируете обучение операторов и понятные инструкции по валидации.
Простой пример: бухгалтерия сканирует счета и акты, а СЭД требует строгие метаданные. Если дата распознана как 01.11.2025 вместо 11.01.2025, без валидации документ уйдет «не туда», и его будет сложно найти. На пилоте просите показать, как платформа предотвращает такие ошибки и как оператор исправляет их за 10-20 секунд.
Если у вас уже есть СЭД и требования по локальной инфраструктуре, системный интегратор (например, GSE.kz) помогает заранее описать сценарии отказов и критерии качества, чтобы сравнение Kofax, ABBYY FlexiCapture и Ephesoft было честным и практичным.
Короткий чек-лист и следующие шаги
Хорошая capture-платформа должна давать предсказуемое качество данных, а не только красивую схему. Сведите сравнение к измеримым цифрам.
Минимальные проверки на пилоте
Возьмите один и тот же тестовый набор (разные шаблоны, качество печати, сканы и фото) и прогоните через всех кандидатов. Дальше фиксируйте результаты по единой форме: точность по ключевым полям (ИИН/БИН, номер и дата, сумма, контрагент) с примерами ошибок; доля ручной проверки (сколько документов уходит в валидацию и сколько времени тратит оператор); скорость обработки (документов в час при реальной нагрузке, включая валидацию); интеграция (стабильная выгрузка в СЭД/архив, корректные метаданные, имя файла и формат); устойчивость к сбоям (очередь, повторы, журнал ошибок при падении сети или недоступности СЭД).
Отдельно проверьте эксплуатацию: мониторинг очередей и статусов, отчеты по качеству и производительности, права доступа по ролям и аудит действий оператора и администратора.
Что подготовить к закупке и внедрению
Сильнее всего экономит время не выбор бренда, а подготовка входных данных и правил оценки. Перед закупкой обычно достаточно четырех артефактов: требования (обязательные и желательные), тестовый набор, матрица оценки (вес критериев) и план пилота с метриками успеха.
Дальше двигайтесь короткими итерациями: пилот 2-4 недели на реальном потоке и фиксация KPI (точность, доля ручной обработки, SLA по выгрузке); проектирование интеграции с СЭД/архивом (формат метаданных, обработка ошибок, права и аудит); планирование инфраструктуры (серверы, хранение, резервирование, мониторинг); подготовка эксплуатации (регламенты, обучение, поддержка).
Если нужен единый контур «под ключ» - от инфраструктуры до интеграций и сопровождения - имеет смысл заранее обсудить это с интегратором. В Казахстане такие проекты часто ведут команды уровня GSE.kz (gse.kz), а для развертывания внутри периметра дополнительно пригодится вариант с локальными серверами и рабочими станциями отечественного производства.
Частые вопросы
Чем capture-платформа отличается от обычного OCR?
Capture — это входной конвейер для документов: он принимает сканы, определяет тип документа, вытаскивает нужные поля, проверяет сомнительные места и передает результат дальше. СЭД и архив начинаются там, где появляются карточки, маршруты согласования, права доступа, поиск и хранение.
С чего начать, если нужно сравнить Kofax, ABBYY FlexiCapture и Ephesoft?
Сначала опишите ваш реальный поток: какие типы документов, какие поля обязательны, какие есть многостраничные пакеты, печати, подписи и «кривые» сканы. Затем зафиксируйте измеримые цели: долю ручной проверки, время попадания в СЭД, требования к размещению (внутри периметра) и роли пользователей.
Почему нельзя выбирать платформу по красивому демо?
Демо почти всегда показывают на идеально подготовленных шаблонах и хорошем качестве, поэтому оно не отражает реальный поток. Просите прогон на ваших документах и оценивайте, сколько ручной работы останется после запуска: разбор пачек, исправления полей, повторные отправки в СЭД.
Какой тестовый набор документов нужен для пилота?
Соберите 200–500 документов из реального потока и добавьте «плохие» случаи: перекосы, бледная печать, штампы поверх текста, фото с телефона, разные версии одного и того же бланка. Важно, чтобы тест включал именно те поля и типы документов, которые дают основную нагрузку и ошибки.
На что смотреть в классификации документов?
Важнее не «лучший ML», а сколько усилий уйдет на доводку и поддержку качества. Проверьте стабильность определения типа на похожих формах, работу с баркодами и листами-разделителями, а также то, как система режет смешанную пачку на отдельные документы и где ошибается на границах.
Как правильно проверять извлечение полей и качество OCR?
Проверяйте не «OCR в целом», а ваши конкретные реквизиты: ИИН/БИН, даты, суммы, номера, контрагента и таблицы. Отдельно тестируйте ошибки символов вроде 0/О и 1/І, работу со штампами и подписью, а также извлечение из многостраничных документов, где нужное поле может быть на разных страницах.
Какие проверки лучше заложить в валидацию сразу?
Ставьте понятные правила: формат и длина, обязательность, логические проверки по датам и суммам, а также сверку со справочниками и внешними системами. Хорошая схема — когда платформа отправляет на проверку только то, что действительно сомнительно, и при этом фиксирует, кто и что исправил.
Что важно в интеграции capture с СЭД и архивом?
Проверяйте полный путь: создание карточки, прикрепление файлов, заполнение метаданных, обработку приложений, версионность и повторную отправку при сбоях. Если выгрузка сделана как «просто сложить файлы в папку», на большом потоке это быстро превращается в ручной разбор и потери по контролю.
Как оценить производительность и устойчивость на нагрузке?
Смотрите на время прохождения от сканера до СЭД при реальных пиках, а не на паспортные «страницы в минуту». Важны очереди, приоритеты, параллельная обработка, поведение при падении сети или узла, а также наличие мониторинга и понятных логов, чтобы быстро находить узкие места.
Какие вопросы задать про безопасность и лицензии перед закупкой?
Уточните, где хранятся изображения и извлеченные данные, есть ли шифрование, разграничение прав по ролям и аудит действий операторов и администраторов. По стоимости заранее проясните модель лицензирования (страницы, пользователи, модули, серверные роли), правила учета пиков и что будет стоить масштабирование и тестовая среда.
