6 мин
Поддержка бизнес-систем по расписанию для SMB: как настроить
Поддержка бизнес-систем по расписанию: как выбрать окна обслуживания, настроить уведомления, роли и эскалации, чтобы SMB работал стабильно без 24/7 дежурств.
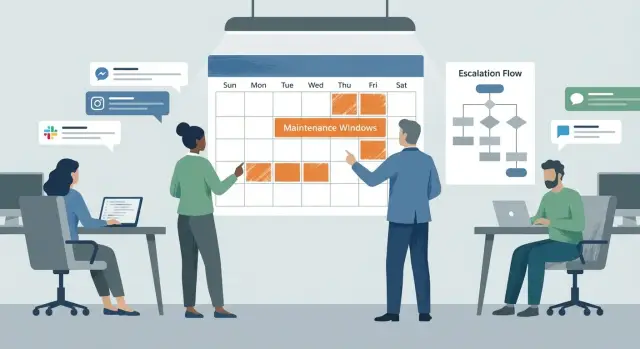
Зачем SMB поддержка по расписанию, а не 24/7
Для большинства SMB круглосуточные дежурства выглядят как «правильная» забота о бизнесе, но на практике часто превращаются в дорогую привычку. Ночные инциденты бывают редко, а платить приходится постоянно: за смены, повышенные ставки и ошибки от усталости.
Есть и человеческая сторона. Когда один и тот же человек «вечно на телефоне», растет выгорание, затем текучка. Поддержка становится непредсказуемой: кто-то отвечает «как получится», задачи теряются, решения принимаются в спешке.
При этом у SMB обычно ломается не «все подряд», а понятный набор ключевых вещей: 1С/ERP и интеграции, почта и календари, файловые ресурсы, сеть и VPN между офисом и филиалами, кассы и рабочие места в торговой точке.
Поддержка по расписанию означает заранее заданные часы, правила приема обращений и ясные границы ответственности. Например: заявки принимаются с 9:00 до 18:00, критические инциденты в эти часы имеют приоритет, а вне часов есть отдельный порядок действий только для действительно «красных» ситуаций.
Хороший результат для бизнеса не в том, чтобы «кто-то был доступен всегда». Результат в том, чтобы ожидания стали ясными: что считается инцидентом, когда будет реакция, кто принимает решение и что делать до ответа поддержки. Так простоев меньше, потому что меньше хаоса.
Пример: бухгалтерия не может провести платежи из-за сбоя 1С в 16:30. По расписанию инцидент получает высокий приоритет, назначается ответственный, пользователям сразу уходит короткое сообщение: «работаем, следующий апдейт через 30 минут». Если та же проблема всплывает в 22:00, включается другой сценарий: фиксируем факт, применяем безопасный временный обходной путь и переносим полноценное восстановление в ближайшее окно обслуживания.
Для SMB это часто самый честный баланс: контролируемые расходы, живые люди в поддержке и предсказуемая надежность сервисов.
Определяем критичность и типы обращений
Чтобы поддержка по расписанию работала, сначала договоритесь о простых правилах: что для вас критично и какие обращения вообще бывают. Без этого любая очередь превращается в спор о том, «у кого громче».
Критичность лучше определять не по названию системы, а по последствиям. Если остановка сервиса напрямую останавливает продажи, отгрузки, прием платежей или производство, это критично. Если неудобно, но бизнес продолжает работать (отчет не строится, печать срабатывает не с первого раза, сбилась форма), это некритично и должно решаться по плану.
Дальше разделите обращения по типу. Обычно хватает трех категорий:
- Инцидент: что-то сломалось и работает хуже или не работает.
- Запрос пользователя: доступ, консультация, «как сделать», мелкая помощь.
- Изменение: обновление, настройка, перенос, доработка, все, что может повлиять на работу системы.
Добавьте срочность. Удобно держать три уровня: авария, высокая, плановая.
- Авария - остановка критичного процесса или риск потери данных.
- Высокая - процесс сильно замедлен, есть обходной путь, но он дорогой или нервный.
- Плановая - все остальное, что можно поставить в ближайшее окно.
Заранее назначьте, кто решает приоритет. Для SMB хорошо работает схема: ИТ фиксирует факты (что сломалось и как влияет), а финальный приоритет подтверждает бизнес-владелец системы (руководитель продаж, бухгалтерии, склада). Тогда «срочно» становится измеримым.
Пример: в 16:30 касса не пробивает чеки - это авария. Если в CRM не открывается один отчет, но сделки ведутся - высокая или плановая, в зависимости от влияния на дедлайны. Если просят добавить пользователя или поменять шаблон печати - это запрос/изменение и уходит в ближайшее согласованное окно.
Как выбрать окна обслуживания без боли для бизнеса
Окно обслуживания работает только тогда, когда оно опирается на факты, а не на привычку «после шести всем удобно». Начните с простого: когда система реально нужна людям. Часто выясняется, что бухгалтерия активна до позднего вечера в конце месяца, а склад стартует раньше офиса. Если есть филиалы, учитывайте их график и часовые пояса.
Соберите карту использования по отделам и точкам: короткие интервью, данные о пиках входов в систему, расписание смен, даты отчетности. Это занимает 1-2 дня, но экономит недели споров.
Дальше выберите 1-2 регулярных окна и сделайте их предсказуемыми. Для SMB лучше «всегда одинаково», чем «как получится». Например: короткий слот в будни вечером и более длинный слот в выходной.
Окна удобно делить по типу работ: короткие (15-30 минут) для мелких изменений и перезапусков, длинные (2-4 часа) для обновлений и миграций, плюс отдельный «запасной» слот раз в месяц, если обновление не уложилось.
Проверьте, не конфликтуют ли окна с регламентными задачами. Резервное копирование, закрытие месяца, выгрузки отчетов, обмен с банком или маркировкой часто идут ночью или рано утром. Если обновлять систему в то же время, проблемы будут выглядеть как «все зависло», хотя причина в расписании.
И заранее согласуйте допустимый простой в цифрах. Не «нельзя долго», а, например: «в рабочие часы не более 10 минут», «в вечернем окне до 60 минут». Пример: офис в Алматы и филиал в регионе используют общую 1С и файловый сервер. В обычные недели хватает 20 минут в будни, но на неделе закрытия месяца длинное окно лучше перенести на выходной, чтобы бухгалтерия не останавливалась.
Базовые правила: часы поддержки, роли, уровни сервиса
Чтобы расписание не превратилось в хаос, правила нужно зафиксировать заранее. Они снимают главные споры: когда вас можно беспокоить, кто принимает решение и что считается срочным.
Начните с часов работы поддержки в двух разрезах: время приема обращений и время выполнения работ. Например, заявки принимаются с 09:00 до 18:00 в будни, а плановые работы выполняются в ближайшее окно обслуживания по согласованию. Это честнее, чем обещать «починим сразу» на любой запрос.
Дальше определите каналы. Для SMB достаточно одного основного канала для всех заявок (чтобы ничего не терялось) и одного аварийного - только для критичных случаев. Аварийный канал должен быть громким и редким, иначе его начнут использовать для всего.
Роли лучше закрепить письменно, даже если команда маленькая. Минимальный набор:
- Диспетчер: принимает обращение, уточняет, ставит приоритет, держит связь с пользователем.
- Исполнитель: диагностирует, исправляет, пишет короткий итог.
- Владелец системы: подтверждает приоритет для бизнеса и принимает компромиссы.
- Утверждающий изменения: дает добро на рискованные правки и окна.
- Резервный ответственный: закрывает отпуск, больничный, командировки.
Уровни сервиса проще задавать через два времени: реакция и восстановление (или обходной способ). Не усложняйте: обычно хватает 3 уровней срочности. Пример: критично (простой продаж/платежей) - реакция 15-30 минут в рабочие часы, восстановление 2-4 часа; средне - реакция до 4 часов, восстановление 1-2 рабочих дня; низко - реакция на следующий день, выполнение по плану.
Зафиксируйте исключения: праздники, закрытие месяца, сезонные пики, дни инвентаризации. В такие периоды правила часто меняются: меньше плановых изменений, больше контроля и заранее согласованные окна.
Пошагово: внедряем поддержку по расписанию за 2-4 недели
Переход проходит легче, если сначала навести порядок в информации, а уже потом вводить ограничения. План ниже обычно укладывается в 2-4 недели даже при небольшой команде.
Неделя 1: собираем основу
Соберите единый реестр: какие системы поддерживаем (почта, 1С, файлы, VPN, кассы, Wi-Fi), где они находятся, кто владелец со стороны бизнеса и кто отвечает со стороны ИТ или подрядчика. Рядом держите контакты для срочных случаев и понятные часы доступности.
Параллельно введите простой шаблон обращения. Сотруднику должно быть ясно, что написать: что не работает, у кого, когда началось, что уже пробовали, и что приложить (скрин, текст ошибки, номер рабочего места). Это резко снижает переписку.
Недели 2-4: вводим календарь и контроль
Закрепите окна обслуживания и правило «заморозки»: в дни закрытия месяца или перед важной отгрузкой - никаких обновлений, кроме аварийных.
Чтобы расписание не развалилось, добавьте короткий ежедневный контроль и минимум бюрократии:
- Календарь окон обслуживания на ближайший месяц.
- Понятные запреты на период «заморозки» и кто может их снять.
- Единый формат заявки (текст, время, контакт, скриншоты).
- Ежедневная 10-минутная сверка: что критично, что в работе, что блокирует бизнес.
- Ежемесячный обзор: повторяющиеся инциденты, пики по времени, где нужны новые правила.
Пример: если филиалы жалуются, что «тормозит 1С» по понедельникам, обзор быстро покажет повторяемость. Тогда тяжелые обновления переносите на середину недели, а в понедельник усиливаете контроль в рабочие часы.
Коммуникации: как предупреждать и не перегружать людей
Коммуникации решают половину проблем при переходе на расписание. Если люди заранее знают, что меняется и что им делать, обращений меньше, а конфликтов почти нет.
Сначала определите, кого нужно уведомлять. Обычно это не только пользователи, но и руководители подразделений (чтобы планировали работу), внешние подрядчики (например, бухгалтерия на аутсорсе), а также те, кто физически на объекте в нерабочие часы: охрана или дежурные администраторы здания.
Держите понятный ритм уведомлений:
- за 3-5 дней - чтобы команды успели перестроить задачи;
- за сутки - чтобы никто не планировал критичные операции;
- за час - короткое напоминание тем, кого реально затронет;
- после завершения - подтверждение и куда писать, если что-то пошло не так.
Текст должен быть простым: что будет недоступно, когда, на сколько и что сделать заранее. Например: «С 19:00 до 20:00 не будет работать печать накладных. Сохраните черновики до 18:50. Если печать нужна срочно, отправьте запрос до 17:00».
Два формата одного сообщения
Удобно держать две версии: короткую и подробную. Короткую отправляйте всем, подробную - только тем, кого затрагивает процесс (руководители, ключевые пользователи, подрядчики). В подробной добавьте список затронутых сервисов, план отката и контакт для эскалации в рамках рабочих часов.
Обратная связь без хаоса
Разведите вопросы и проблемы по двум каналам: один для уточнений до окна обслуживания, второй - для фиксации проблем после работ по шаблону (что не работает, у кого, когда началось). Тогда обсуждения не смешиваются с инцидентами.
Пример: если у вас офис и пара филиалов, отправьте короткое уведомление всем, а подробное - администраторам филиалов и руководителю продаж. Кассиры не получат лишних деталей, а ответственные люди будут готовы к рискам.
Эскалации без 24/7: ясные триггеры и цепочка решений
При поддержке по расписанию самое опасное не «ночь без инженера», а размытые правила: кто решает, что случилось «по-настоящему», и кого будить. Эскалация должна быть короткой и заранее согласованной, иначе люди будут либо дергать всех подряд, либо терпеть слишком долго.
Триггеры эскалации
Зафиксируйте 4-5 событий, при которых обращение сразу повышается в приоритет и запускается цепочка контактов. Например:
- Остановились продажи: учет/CRM недоступны и сделки не оформляются.
- Кассы не пробивают или не уходит фискализация.
- Риск потери данных: ошибки диска/БД, повреждение файлов, не работает резервное копирование.
- Инцидент по безопасности: подозрение на взлом, шифровальщик, утечка.
- Срыв обязательств: не проходит платеж, не работает ключевой канал связи с филиалом.
Нужен один владелец решения об эскалации: чаще это дежурный менеджер со стороны бизнеса (не ИТ), который понимает цену простоя. Обязательно назначьте замену на отпуск и больничный.
Контактное дерево держите простым: 1 линия (прием и первичные действия), 2 линия (админ/инженер), затем поставщик/интегратор, и только потом руководитель ИТ и бизнес-владелец. Важно указать не только имена, но и окна доступности и канал связи.
Что делать ночью без дежурства
Нужен минимальный аварийный план: что можно сделать безопасно без эксперта, и в каких случаях вызываем специалиста вне графика. Частый пример: если кассы не работают, допускается перезапуск приложения по инструкции; если есть признаки шифровальщика - сразу отключить устройство от сети и поднять эскалацию.
После каждого такого случая фиксируйте решения в коротком отчете (10-15 минут): что произошло, какой триггер сработал, кто принял решение, сколько длился простой, что сделали сейчас и что меняем, чтобы не повторилось.
Частые ошибки и ловушки при переходе на расписание
Самая частая проблема - пытаться «перенести» подход 24/7 в расписание, не меняя правила. В итоге никто не понимает, когда можно делать работы, куда писать и кто принимает решение, если что-то пошло не так.
Типовые ловушки:
- Окно обслуживания без бэкапа и плана отката. Даже небольшое обновление может сломать интеграцию. Нужны резервная копия, проверка восстановления и заранее согласованный критерий, когда вы откатываетесь.
- Слишком много каналов. Когда часть запросов приходит в почту, часть в мессенджер, часть в личные сообщения, заявки теряются, а время реакции становится случайным. Оставьте один главный вход и один аварийный.
- Нет владельца системы со стороны бизнеса. Тогда ИТ и подразделения спорят о приоритетах, потому что «важно» у всех разное.
- Не учитывается календарь бизнеса: закрытие месяца, сезонные пики, инвентаризация.
- Обновления без пилотного теста на небольшой группе (3-5 рабочих мест или один филиал).
Отдельная ошибка, которая быстро убивает доверие, - скрывать простой. Предупреждение за день и короткое напоминание за час люди воспринимают спокойно. Постфактум приходится объяснять не только сбой, но и почему о нем никто не знал.
Быстрый чеклист: все ли готово к работе без ночных дежурств
Переход на поддержку по расписанию работает только тогда, когда правила понятны заранее. Этот чеклист помогает быстро увидеть пробелы до первого «пожара» вечером.
Чеклист готовности
- Окна обслуживания закреплены в календаре на 1-2 месяца вперед, и о них знают все отделы (не только ИТ).
- По каждой ключевой системе назначен владелец (кто принимает решения) и есть замена на отпуск и болезни.
- Разделены каналы: куда писать по обычной заявке, а куда по аварии (описано одним абзацем, без «догадайтесь сами»).
- Есть 3 уровня срочности и для каждого указано ожидаемое время реакции в рабочие часы.
- Перед любыми плановыми работами делается бэкап, и есть простой план отката (кто, что и за сколько минут возвращает обратно).
После этого проговорите один конкретный пример, чтобы все одинаково понимали правила. Например: «в 19:30 касса в филиале не печатает чек». Это авария или заявка? Кто решает, можно ли ждать до утра? Как быстро человек получит ответ и что ему делать прямо сейчас?
Мини-ритуал после инцидента
Договоритесь о коротком разборе после каждого заметного сбоя: 10 минут по фактам. Что случилось, почему не заметили раньше, что меняем в настройках, инструкциях или окнах обслуживания.
Пример сценария для SMB: офис и филиалы
Компания на 80 сотрудников: головной офис, склад и два небольших филиала. Основные системы - 1С для продаж и учета, почта, общие файлы и принтеры. ИТ-ресурс небольшой: один админ и подрядчик на сложные задачи.
Раньше обновления ставили «когда получится»: вечером после работы, в обед, иногда в пятницу. Пользователи узнавали о простое в последний момент, а руководители видели только последствия: касса «встала», склад не отгружает, в филиале не печатаются накладные.
Компания закрепила календарь и правило предупреждения заранее:
- Вторник и четверг, 19:30-21:00 - короткие окна (патчи, перезапуски, мелкие настройки).
- Первая суббота месяца, 10:00-13:00 - длинное окно (обновления 1С, плановые работы на сервере, тест восстановления).
- Изменения вне окон запрещены, кроме аварий.
Коммуникации сделали простыми. Используют один канал для заявок и отдельное уведомление руководителям подразделений. Предупреждают за 24 часа и за 1 час. Шаблон короткий: что делаем, кого затронет, сколько займет, что нельзя делать в этот период, куда писать при проблеме после окна.
Для редких экстренных случаев оставили один аварийный телефон с четкими триггерами: остановилась продажа/отгрузка, недоступна почта для всех, филиал полностью без связи. Если проблема затрагивает один ПК, это не авария и уходит в очередь.
Через 3-4 недели стало заметно: меньше неожиданных остановок, сотрудники планируют работу вокруг окон, руководители понимают, когда ждать изменений и кто принимает решение об эскалации. Даже если что-то идет не по плану, ожидания прозрачные и конфликтов меньше.
Следующие шаги: закрепляем процесс и проверяем инфраструктуру
Чтобы расписание работало, зафиксируйте его не только в чате, но и в документах, календарях и настройках. Начните с инвентаризации: список бизнес-систем (1С, почта, телефония, CRM, файлы, VPN), владельцы и зависимости. Затем вместе с руководителями согласуйте критичность: что можно чинить утром, а что останавливает продажи прямо сейчас.
Утвердите календарь окон обслуживания минимум на квартал вперед. Он должен быть понятен всем: когда возможны перерывы, кто уведомляет, что считается плановыми работами.
Чтобы не было паники вне рабочих часов, сделайте регламент эскалации на одной странице и проведите короткий инструктаж. Достаточно ответить на пять вопросов:
- Что считается аварией и кто это решает.
- Как быстро надо сообщить и по какому каналу.
- Кто принимает решение о срочном вмешательстве.
- Что делать, если ответственный недоступен.
- Как фиксировать итог и обновлять знания.
Параллельно проверьте инфраструктуру. Поддержка без ночных дежурств держится на профилактике и ранних сигналах, а не на героизме: резервное копирование с тестом восстановления, мониторинг диска/памяти/сети и критичных сервисов, план быстрой замены для ключевого оборудования, безопасный удаленный доступ и актуальная документация (схемы, контакты провайдеров, серийные номера).
Простой пример: если филиалы зависят от VPN, добавьте мониторинг доступности туннеля и подготовьте замену роутера. Тогда большинство сбоев решается в рабочее окно, а не ночью.
Если не хватает рук или опыта, логично подключать системного интегратора, который поможет настроить процессы и инфраструктуру. В Казахстане этим занимается GSE.kz (gse.kz): системная интеграция, инфраструктурные решения для дата-центров и поставка локально произведенных ПК и серверов, включая серии L200 и S200, с поддержкой на всем жизненном цикле оборудования.
Частые вопросы
Кому подходит поддержка по расписанию?
Поддержка по расписанию подходит компаниям, где ночные сбои редки, а основные процессы можно защитить правилами и профилактикой. Она помогает держать расходы под контролем и не перегружать небольшую ИТ-команду.
Что считать аварией вне рабочих часов?
Аварией считают событие, которое останавливает продажи, отгрузки, прием платежей, производство или создает риск потери данных. Проблема на одном компьютере или сбой отдельного отчета обычно идет в обычную очередь.
Как определить срочность заявки?
Обычно достаточно трех уровней: авария, высокая и плановая. Оценивайте не название системы, а ущерб для работы: остановились ли продажи, есть ли безопасный обходной путь и сколько людей затронуто.
Какие часы поддержки лучше установить SMB?
Установите отдельные часы приема обращений и отдельные окна для плановых работ. Например, заявки принимают в будни с 9:00 до 18:00, а обновления выполняют вечером или в выходной по согласованному календарю.
Как выбрать время для обслуживания систем?
Соберите графики отделов, смены, даты закрытия месяца и время пиковых операций. Не ставьте обновления одновременно с резервным копированием, банковскими обменами или отчетностью.
Как принимать заявки, чтобы они не терялись?
Оставьте один основной канал для обычных заявок и отдельный аварийный канал. В заявке сотрудник должен указать, что не работает, у кого возникла проблема, когда она началась и приложить текст ошибки или скриншот.
Кто должен решать, насколько проблема срочная?
ИТ описывает технические факты и варианты решения, а бизнес-владелец системы подтверждает приоритет по влиянию на работу. Для 1С это может быть главный бухгалтер, для продаж - руководитель отдела продаж.
Как сообщать сотрудникам о плановых работах?
Предупреждайте затронутых сотрудников заранее: за несколько дней, за сутки и коротко за час до работ. Сообщение должно содержать время, затронутые сервисы, ожидаемую длительность и действия, которые пользователям нужно сделать заранее.
Как снизить риск сбоя во время обновления?
Перед работами сделайте резервную копию, проверьте возможность восстановления и согласуйте понятный план отката. Сначала тестируйте заметные обновления на небольшой группе компьютеров или в одном филиале.
Что делать при ночном инциденте без дежурного инженера?
Подготовьте короткую инструкцию: кто принимает решение, кому звонить, какие безопасные действия допустимы и когда нужно вызвать специалиста. При подозрении на шифровальщик отключите устройство от сети и сразу запускайте эскалацию.
