8 мин
Карта миграции на open source для ИТ-директора: слои и риски
Карта миграции на open source: как разложить замену ПО по слоям, зафиксировать критерии успеха, сроки и владельцев, а также заранее увидеть зоны риска.
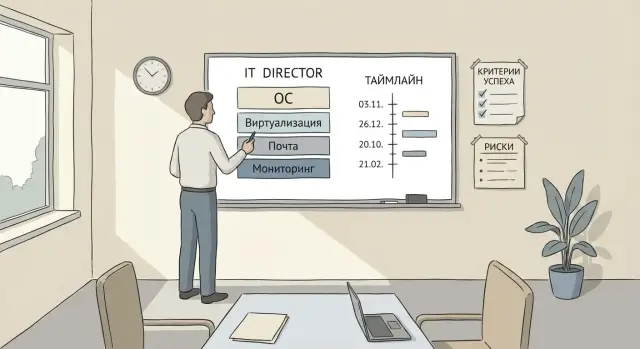
Зачем нужна карта миграции и почему без нее все затягивается
Идея «просто заменим продукт» почти всегда разбивается о зависимости и людей. Коммерческий инструмент обычно встроен в десяток процессов: авторизация, резервное копирование, интеграции с бухгалтерией, привычки пользователей, регламенты поддержки. Без карты вы начинаете менять один блок, а потом внезапно выясняется, что от него зависят критичные сервисы. Проект останавливается на согласованиях, появляются срочные обходные решения, сроки расползаются.
Карта миграции на open source - это понятная схема, где замена разложена по слоям. В ней заранее отмечено, что от чего зависит, в каком порядке двигаться и где будут точки возврата. Это не «список задач», а «план полета»: что делаем сначала, что трогаем только после, и что будет, если на пилоте что-то пойдет не так.
Обычно раньше затрагивают то, что проще изолировать и проверить: мониторинг и логирование, затем виртуализацию или тестовые среды. Позже переходят к слоям, где больше влияния на пользователей и процессы: рабочие места и почта. Причина простая: сбой в мониторинге неприятен, но сбой в почте или на рабочих местах заметит весь офис.
Есть решения, которые нельзя принимать вслепую: выбор ОС, платформы виртуализации, способа аутентификации, модели резервного копирования и поддержки. Пока вы не понимаете, какие сервисы действительно критичны (ERP, доменная инфраструктура, телефония, медицинские системы и т.д.), вы не сможете честно оценить сроки, риски и минимально допустимые простои. Карта нужна, чтобы зафиксировать реальность до того, как начнутся закупки, миграции и спор «кто виноват».
Инвентаризация: что именно вы заменяете и кто пострадает
Инвентаризация нужна не ради красивой таблицы. Она отвечает на главный вопрос: что именно делает каждый коммерческий продукт в вашей компании. Лицензия в бюджете не равна функции в жизни пользователей. Один продукт часто закрывает сразу несколько задач (например, почта + календарь + архив + мобильный доступ), и это важно увидеть до выбора замены.
Начните с короткого описания по каждому решению: функции, где стоит, кто пользуется, кто владелец. Владелец системы (не подрядчик, а человек внутри) должен подтвердить, какие сценарии критичны и что будет считаться поломкой.
Чтобы карта миграции была реальной, зафиксируйте минимум:
- продукт и его фактические функции (как используют сегодня, а не как «должно быть»)
- владельца, ключевых пользователей и «дежурных» по инцидентам
- интеграции: AD/LDAP, почта, файловые ресурсы, резервное копирование, мониторинг
- критичность и допустимые окна простоя (что нельзя останавливать, а что можно переводить поэтапно)
- базовые метрики: аптайм, время реакции на инцидент, объемы данных, число ящиков/ВМ
Пример: если в госсекторе почта завязана на доменную аутентификацию и архив, при замене пострадают не только пользователи, но и служба ИБ, делопроизводство и поддержка. Без списка интеграций и метрик вы не поймете, где вы реально «ухудшили», а где просто поменяли привычный интерфейс.
Разложение по слоям: зависимости, порядок и точки возврата
Хорошая карта миграции начинается не с выбора дистрибутива, а со схемы слоев. Она помогает не путать причины и следствия: если «падает почта», проблема часто не в почте, а в DNS, времени или сертификатах.
Удобно рисовать слои так, чтобы снизу были базовые вещи, а выше - сервисы для пользователей:
- железо и прошивки
- сеть (VLAN, маршрутизация, DNS)
- ОС и базовая конфигурация
- виртуализация и хранилища
- идентификация (учетки, группы, MFA)
Дальше подпишите зависимости. Например, почта и совместная работа зависят от DNS, корректного времени (NTP) и цепочки сертификатов. Мониторинг и логирование зависят от сети и прав доступа, а также от того, где будут храниться данные и как долго.
Отдельно отметьте общие сервисы, которые затрагивают всех сразу: учетные записи, время, DNS, почта. Их лучше трогать либо в самом начале через аккуратный пилот, либо после того, как фундамент стабилен.
Точки отката фиксируйте заранее. Практичные варианты: параллельная работа двух почтовых доменов на период миграции, сохранение старого гипервизора до окончания проверки резервных копий, «заморозка» части групп пользователей на прежней ОС.
И заранее согласуйте допущения: где допустим гибрид (например, часть ВМ еще на старой платформе), а где нужен полный переход из-за требований регуляторов или поддержки. Это снижает число спорных ситуаций и помогает удерживать сроки.
Критерии успеха: как измерить, что миграция удалась
Успех легко «потерять», если цель звучит как «перейти на open source». В карте цель лучше формулировать языком бизнеса: не остановить работу, снизить риски безопасности, удержать или снизить стоимость владения, не нарушить требования регуляторов и закупок.
Дальше нужны критерии приемки по каждому слою, чтобы слово «работает» было одинаковым для ИТ и пользователей. Для ОС это может быть список поддерживаемых моделей ПК и сценариев (печать, ЭЦП, VPN). Для виртуализации - перенос ВМ без простоев выше нормы и предсказуемое восстановление. Для почты - доставка, календарь, мобильный доступ, архив. Для мониторинга - покрытие критичных систем и понятные оповещения.
Метрики, которые можно проверить
Выберите несколько чисел, которые вы реально будете мерить каждую неделю:
- RTO и RPO для ключевых сервисов (что и за сколько восстанавливаем)
- MTTR по инцидентам (среднее время восстановления)
- доля успешных резервных копий и тестовых восстановлений
- время доставки почты внутри и наружу
- количество критичных инцидентов после перехода (в сравнении с базовой линией)
Кто принимает результат
Заранее зафиксируйте ограничения: комплаенс, локализация данных, требования к госзакупкам и локальному содержанию (если это важно для вашей отрасли). И отдельно - формат отчетности: кто подписывает этап, какие артефакты нужны (протокол тестов, отчет по метрикам, перечень известных рисков и план их закрытия). Так у миграции появляется четкая «финишная черта», а не бесконечная донастройка.
Пошаговый план работ: от пилота до промышленной эксплуатации
Чтобы карта стала реальным планом, разложите работу на короткие этапы. У каждого должен быть понятный результат, срок и критерий готовности. Начните с целевой архитектуры: какие продукты выбираете по слоям (ОС, виртуализация, почта, мониторинг), какие версии, кто поддерживает, где допустимы компромиссы.
Дальше соберите пилотный контур. Он должен быть похож на «боевую» среду, но с ограниченным риском: часть пользователей, несколько типовых сервисов, копия критичных настроек безопасности и резервного копирования. На пилоте проверяйте не функции «в целом», а сценарии: вход по доменной политике, печать, работа с файлами, мобильная почта, восстановление после сбоя.
Обычно помогает простая последовательность: зафиксировать целевую архитектуру и зависимости, прогнать пилот и закрыть разрывы по ключевым сценариям, разбить перенос на «волны» и составить календарь изменений, обучить админов и первую группу пользователей, затем провести перенос в согласованное окно с планом отката.
После запуска результат важно закрепить, иначе через месяц начнется «тихий откат» в старые привычки. Минимум, который стоит проверить: мониторинг и алерты на новые компоненты, резервные копии с тестом восстановления, регламенты и ответственные по поддержке.
Если вы обновляете серверную часть и рабочие места одновременно, сначала стабилизируйте виртуализацию и наблюдаемость, и только потом расширяйте волну пользователей. Если нужны отечественные поставки и единая ответственность за интеграцию и поддержку, GSE.kz часто подключают уже на этапе пилота, чтобы заранее согласовать конфигурации серверов и рабочих станций, сроки поставки и сервисную модель.
Слой ОС: стандартизация, безопасность и поддержка рабочих мест
Слой ОС обычно выглядит «простым», пока не начинаются сотни мелких исключений: разные модели ПК, драйверы, привычные утилиты, политики доступа. Поэтому этот слой стоит описать максимально конкретно: что считается стандартом, а что - временным компромиссом.
Начните со стандартного образа: одна-две версии ОС, набор драйверов, единые базовые настройки безопасности (шифрование, блокировка экрана, запрет лишних прав). Чем меньше вариантов, тем проще поддержка и обучение.
До массового перевода проверьте совместимость с периферией и «болезненными» приложениями. Чаще всего всплывают принтеры, сканеры, токены для подписи, бухгалтерские клиенты и специализированные мед- или учебные системы. На пилоте фиксируйте не только «работает/не работает», но и что именно придется менять: устройство, процесс или программу.
Чтобы ОС не превратилась в зоопарк, заранее договоритесь об управлении обновлениями и репозиториями. Полезно закрепить: кто утверждает обновления и как часто, как быстро ставятся критические патчи, как откатываться при сбое, где хранится эталонный образ и кто его меняет, как ведется учет исключений.
Отдельно продумайте интеграцию с доменом/каталогом и политиками доступа, чтобы сотрудники не потеряли привычный вход и права. И сразу заложите резервное копирование конфигураций плюс короткую документацию для первой линии поддержки, особенно если у вас большой парк ПК и моноблоков в офисе, учебных классах или на стойках ресепшена.
Слой виртуализации: кластеры, хранилища и план переноса ВМ
Виртуализация часто держит на себе все: бизнес-приложения, тестовые среды, резервное копирование, аварийное восстановление. Поэтому в карте этот слой лучше описывать не как «заменить гипервизор», а как платформу целиком: гипервизор + кластер + сеть + хранилище + бэкап.
Сначала зафиксируйте цели. Это может быть консолидация хостов, отказоустойчивость без ручных действий, быстрый запуск тестовых сред или предсказуемое время восстановления после сбоя. Без четкой цели легко получить «работает», но с худшими простоями и более сложной эксплуатацией.
Дальше сравните варианты по всей цепочке. Один и тот же гипервизор дает разный результат в зависимости от того, как устроены кластеры, где лежат диски ВМ и как делается резервное копирование.
Что проверить до выбора платформы
- поддержку вашего железа и драйверов (HBA/RAID, сетевые карты, при необходимости GPU)
- архитектуру хранилища: производительность, задержки, репликация, снапшоты
- сеть: пропускную способность, изоляцию трафика, отказоустойчивость
- резервное копирование ВМ: частоту, гранулярность восстановления, тест восстановления
- запас ресурсов: рост нагрузки, репликацию, окно для обслуживания
План переноса ВМ лучше писать как сценарий. Проверьте совместимость форматов дисков и способов миграции: где возможна «живая» миграция, а где будет остановка. Для каждой группы ВМ задайте окно простоя, порядок, критерии возврата и тест производительности после переноса.
Практичный подход: сначала перенести некритичные тестовые ВМ и внутренние сервисы, измерить IOPS и задержки, отработать восстановление из бэкапа, и только потом идти в ключевые системы. Если вы обновляете парк серверов под кластер, заранее уточните, что выбранные узлы и контроллеры будут поддерживаться весь срок эксплуатации. Здесь полезны поставщики, которые берут на себя и производство, и интеграцию, и поддержку - например локальные производители и интеграторы вроде GSE.
Слой почты и совместной работы: сценарии, перенос и коммуникации
Почта ломает миграцию чаще всего не из-за технологий, а из-за привычек. Начните с описания реальных сценариев: кто и как пользуется почтой, календарем и контактами, есть ли общие ящики, делегирование, рассылки, мобильные клиенты, архив и юридически значимая переписка. Эти сценарии лучше фиксировать не «в целом по компании», а по ролям (секретариат, продажи, служба поддержки, руководители).
Дальше выберите подход к переходу. Самый безопасный вариант - параллельная работа на время, когда часть пользователей уже на новой системе, а часть еще на старой. Иногда удобнее мигрировать по группам (например, один филиал за раз) или по доменам, если их несколько. Важно сразу определить точку возврата: при каких условиях вы откатываетесь и сколько времени на это нужно.
Перед переключением подготовьте почтовую «обвязку»: DNS-записи, SPF/DKIM/DMARC, сертификаты, антиспам и правила маршрутизации. Если делать это в последний день, вы рискуете получить хаос с доставкой и массовые жалобы.
Перенос данных планируйте как логистику. Зафиксируйте объемы ящиков, скорость выгрузки, окно миграции и способ проверки целостности (выборочно по пользователям и по критичным папкам). Отдельно проверьте права доступа к общим ящикам и календарям - именно они чаще всего «теряются».
Коммуникации с пользователями - часть плана. Заранее подготовьте короткие инструкции (веб, ПК, телефон), шаблоны писем о сроках и изменениях, тестовую группу «ранних пользователей», горячую линию в дни переключения и понятный регламент эскалации.
Если у вас нет ресурсов на поддержку в режиме 24/7, стоит заранее договориться о внешней линии поддержки (например, через интегратора), чтобы дни переключения не превращались в ручное тушение пожаров.
Слой мониторинга и логирования: чтобы миграция не была вслепую
Мониторинг и логи лучше подтянуть раньше, чем трогать критичные сервисы. Иначе вы меняете платформу, а понять, стало ли лучше или хуже, будет невозможно.
Начните с минимального набора наблюдаемости. Для большинства компаний достаточно трех потоков: метрики (нагрузка и емкость), логи (что реально происходит), события (перезапуски, ошибки, изменения). Трассировку добавляйте только если у вас много микросервисов и без нее вы не находите причины задержек.
Дальше договоритесь о правилах игры. Зафиксируйте SLO и пороги: что считается инцидентом, через сколько минут он становится аварией, кто принимает первый звонок и кто подключается вторым. Без этого алерты превращаются в шум, и команда быстро перестает им верить.
Дашборды разведите по аудиториям: руководству нужны доступность ключевых сервисов, количество инцидентов и выполнение SLO; инженерам - CPU, память, диски, задержки, ошибки, очереди задач и зависимости.
Отдельно продумайте хранение логов: сроки, права доступа, маскирование чувствительных данных и место хранения (особенно в госсекторе и финсекторе). На практике это часто важнее, чем выбор конкретного инструмента.
Проверьте интеграции еще до пилота: уведомления (почта, мессенджер), создание тикетов, эскалации, еженедельные отчеты. Простой тест: «уроните» тестовый сервис на стенде и посмотрите, как быстро и по каким каналам команда узнает об этом.
Зоны риска и как их фиксировать в карте миграции
Риски лучше не обсуждать «на словах», а записывать прямо в карту рядом с каждым слоем. Тогда видно, где вы можете потерять сроки, качество или доверие пользователей, и кто отвечает за профилактику.
Удобный формат - таблица рисков. Для каждого пункта достаточно шести полей:
- риск (что может пойти не так)
- признак (как вы поймете, что риск начинает сбываться)
- влияние (простой, деньги, безопасность, репутация)
- вероятность (низкая, средняя, высокая)
- меры (что делаем заранее и что делаем при инциденте)
- ответственный и дата контроля
Типовые риски по слоям часто повторяются.
Нехватку компетенций фиксируйте не общими словами, а планом: какие темы учим, кому выделяем время, кто менторит, где нужна внешняя поддержка на пилоте и в первые недели эксплуатации.
Скрытые зависимости находятся интервью и проверкой интеграций. Рядом с сервисом укажите: интерфейсы, порты, учетные записи, сертификаты, интеграции. И добавьте обязательный пункт пилота с реальными сценариями.
Данные и пропускная способность почти всегда недооценивают. Не пишите «перенесем за выходные». Запланируйте тестовую миграцию на реальных объемах, измерьте скорость, окно простоя и точку отката.
Простои из-за DNS и сертификатов снижайте чек-планом: кто меняет записи, где лежат ключи, какие TTL, какие проверки перед и после. Отдельно отметьте коммуникации: сопротивление пользователей снижают ранние «чемпионы» в отделах и короткие инструкции под частые действия (вход, почта, печать, календарь).
Типовые ошибки ИТ-директоров при переходе на open source
Самая частая причина провала миграции - не технологии, а порядок действий. Open source обычно дает больше вариантов, но и больше мест, где можно ошибиться в организации работ.
Классическая ловушка - начинать с почты и совместной работы. Это самый заметный сервис для сотрудников, и его хочется «быстро закрыть». Но без заранее настроенной идентификации (учетки, группы, права), доменных записей и нормальной работы сертификатов вы получите волну жалоб, письма в спаме и хаос с доступами.
Не менее болезненно выбирать продукты «по обзорам» без пилота на реальных сценариях. Лаборатория показывает, что система запускается, но не показывает, как она ведет себя на ваших пиковых нагрузках, с вашими интеграциями и привычками пользователей.
Еще одна типовая проблема - некому принимать результат. Если не назначить владельца каждого слоя и не зафиксировать критерии приемки по этапам, миграция превращается в бесконечную доработку: «еще чуть-чуть, и будет как раньше».
Перед первой волной часто забывают две вещи: резервное копирование и план отката. Откат должен быть не в голове, а в карте: что возвращаем, сколько это занимает, кто принимает решение, где лежат бэкапы и как проверяем восстановление.
Типовой набор ошибок:
- резкий перевод «всех и всего» за один этап, без волн и ограниченного радиуса
- отсутствие пилота на живых данных и рабочих процессах
- нет ответственных и понятной приемки по каждому сервису
- нет проверенного восстановления и сценария возврата
Пример: компания переводит почту, не проверив DNS и сертификаты. В итоге письма уходят с задержкой, внешние партнеры не получают ответы, а поддержка захлебывается. Этого можно избежать, если сначала закрыть базовые зависимости, сделать пилот на одной группе и только потом расширять волну.
Короткий чек-лист перед стартом и перед каждым этапом
Перед стартом
Карта миграции полезна только тогда, когда ее можно открыть и сразу понять порядок работ. Проверьте, что слои (ОС, виртуализация, почта, мониторинг) разложены в понятной схеме, а зависимости подписаны: что должно быть готово раньше, а что можно делать параллельно.
Дальше зафиксируйте, как вы поймете, что этап успешен. Не общими словами, а метриками: время входа в систему, процент успешных бэкапов, задержка доставки писем, покрытие мониторингом, число инцидентов после переключения.
Перед каждой волной изменений
Перед каждым переносом (даже если это второй или третий слой) коротко пройдитесь по одному и тому же набору вопросов:
- понятно, кто владелец этапа, какие сроки, бюджет и какое окно изменений согласовано с бизнесом
- пилот уже был на реальных пользователях и типовой нагрузке, и есть протокол: что проверяли, что сломалось, что исправили
- подготовлен откат: точка возврата, шаги назад, кто принимает решение, сколько это займет
- резервные копии проверены восстановлением, а не только отчетом о выполнении
- коммуникации готовы: что сказать пользователям, куда писать, как работает поддержка в первые дни
Простой тест на зрелость: если в день переключения ключевые люди действуют по одному листу и не спорят о критериях успеха, вы снижаете риск затяжной миграции и ночных аварий.
Пример сценария: средняя компания и миграция по слоям без героизма
Представьте компанию на 500 сотрудников с двумя площадками (головной офис и филиал). В серверной части - коммерческая виртуализация, корпоративная почта и несколько разрозненных систем мониторинга. Задача ИТ-директора - сделать карту миграции на open source так, чтобы люди почти не заметили изменений, а ИТ не жило в режиме ночных подвигов.
Разбивка на волны помогает не ломать все сразу. Логика простая: сначала ставим глаза и уши, потом переносим основу, и только затем трогаем то, чем пользуются каждый день.
Первая волна - мониторинг и базовые сервисы: единый сбор метрик и логов, оповещения, резервное копирование, тест восстановления. Вторая волна - виртуализация: пилотный кластер, перенос некритичных ВМ, затем основных. Третья волна - почта и совместная работа: пилотная группа, миграция ящиков партиями, финальное переключение доменных настроек и клиентов.
Критерии успеха лучше закрепить цифрами, иначе спор начнется в день сдачи:
- простой критичных сервисов не больше X минут в окно переключения
- реакция поддержки на инцидент - до Y минут (по тикету и по звонку)
- доставка почты внутри домена - до Z минут, без потерь
- восстановление одной ВМ из бэкапа - не дольше N часов
Обычно всплывают три риска. На рабочих местах - периферия (принтеры, сканеры, токены, специфичные драйверы). В почте - архивы и правила, которые копились годами, плюс юридические требования к хранению. Между площадками - пропускная способность: миграция ВМ и почтовых ящиков может забить канал в рабочее время.
День переключения выглядит как короткая операция: назначены дежурные по инфраструктуре, почте, сети и поддержке пользователей. Каждые 30 минут проверяют доступность ключевых сервисов, очередь почты, нагрузку на каналы и число обращений. Если метрики уходят за пороги, включают заранее согласованный план отката и возвращают сервис в прежнее состояние.
Следующие шаги: как превратить карту в план проекта
Когда карта миграции готова, ее нужно «приземлить» в управляемый проект. Хороший признак: любой руководитель ИТ по ней понимает, что делаем, зачем, чем меряем успех и где можем откатиться. Если карта уже есть, следующий шаг - собрать все в один рабочий документ, который будет жить вместе с проектом.
В одном месте зафиксируйте слои, зависимости, «волны» внедрения, критерии успеха, сроки, владельцев и зоны риска. Обязательно добавьте точки возврата: что именно считается причиной отката и сколько времени он займет.
Дальше выберите 2-3 пилота, которые дадут быстрый сигнал о жизнеспособности подхода и не остановят бизнес. Например: отдельный кластер виртуализации для непроизводственных нагрузок, мониторинг для ключевых сервисов или почта для одной группы пользователей с понятными сценариями.
Преобразуйте карту в план на квартал:
- утвердите календарь: пилот, оценка, масштабирование
- назначьте владельцев по слоям и ответственных за коммуникации
- заложите время на обучение и обновление регламентов
- зафиксируйте метрики: доступность, время реакции, число инцидентов
- согласуйте бюджет не только на внедрение, но и на поддержку
Перед стартом проверьте инфраструктурную базу. Часто проблемы возникают не из-за open source, а из-за старых серверов, слабой сети, нехватки резервирования и неясных RTO/RPO.
Если нужен партнер, выбирайте того, кто умеет брать ответственность за инфраструктуру и поддержку 24/7, а не только «поставить и уйти». Для организаций в Казахстане иногда удобен комплексный проект с GSE.kz - системная интеграция плюс подбор отечественных серверов и рабочих станций под целевую архитектуру, с дальнейшей поддержкой.
И держите простое правило управления: каждую волну начинаем только после того, как закрыты критерии успеха пилота и обновлена карта рисков.
Частые вопросы
Зачем вообще делать карту миграции, а не просто начать замену продуктов?
Карта миграции нужна, чтобы заранее увидеть зависимости между сервисами и не останавливать проект на «внезапных» согласованиях. Она фиксирует порядок действий, точки возврата и критерии приемки, чтобы сроки и риски были понятны до начала массовых изменений.
Какие слои лучше закладывать в карту миграции на open source?
В карте обычно выделяют слои от фундамента к сервисам для пользователей: железо и прошивки, сеть и DNS, ОС и базовая конфигурация, виртуализация и хранилища, идентификация и доступы, затем почта, рабочие места и прикладные системы. Такой порядок помогает сначала стабилизировать базу, а уже потом трогать то, что заметит весь офис.
Что именно нужно собрать на этапе инвентаризации?
Начните с фактического описания: что продукт реально делает в компании, где стоит, кто пользуется и кто владелец внутри организации. Дальше добавьте интеграции, критичность и допустимые окна простоя, а также базовые метрики вроде объемов данных и времени реакции на инциденты — без этого невозможно честно оценить сроки и риски.
Почему не стоит начинать миграцию сразу с почты?
Самая частая ошибка — начать с почты или рабочих мест, не закрыв базовые зависимости вроде DNS, времени, сертификатов и аутентификации. Без них даже хороший почтовый сервер будет «ломаться» в глазах пользователей, а поддержка утонет в обращениях.
Что такое «точка отката» и как ее правильно предусмотреть?
Точка отката — это заранее описанный способ вернуться к старому состоянию, если пилот или переключение пошли не по плану. Ее фиксируют в карте до старта работ, чтобы решение об откате было быстрым и понятным: что именно возвращаем, сколько это занимает и кто принимает решение.
Как понять, что миграция действительно удалась, а не просто «что-то запустили»?
Критерии успеха лучше формулировать языком измеримых результатов: доступность сервиса, предсказуемое восстановление, нормальная доставка почты, стабильная работа входа и прав доступа. Когда «работает» превращается в конкретные проверки и цифры, ИТ и бизнес одинаково понимают, что этап завершен.
Какие метрики стоит выбрать для контроля миграции?
Минимальный практичный набор — RTO и RPO для ключевых сервисов, MTTR по инцидентам, доля успешных бэкапов с тестовым восстановлением и метрики, заметные пользователям (например, задержка доставки почты). Важно выбрать немного показателей и мерить их регулярно, а не собирать отчеты раз в конце проекта.
Как организовать пилот, чтобы он дал полезный результат?
Пилот должен быть похож на боевую среду, но с ограниченным риском: часть пользователей, типовые сервисы и реальные сценарии вроде доменного входа, печати, VPN и восстановления после сбоя. Цель пилота — найти разрывы в процессах и интеграциях до массового перевода, а не «доказать, что система запускается».
На что обратить внимание при миграции слоя виртуализации?
Виртуализацию стоит описывать как платформу целиком: гипервизор, кластер, сеть, хранилище и резервное копирование. До выбора и переноса проверьте совместимость с вашим железом, сценарии миграции ВМ и, главное, восстановление из бэкапа на реальном примере — иначе риск простоя окажется выше ожидаемого.
Как снизить сопротивление пользователей и нагрузку на поддержку при переходе?
Нужен короткий план коммуникаций: когда и что изменится, где инструкции, куда писать и кто дежурит в дни переключения. Если внутренних ресурсов поддержки не хватает, имеет смысл заранее договориться о внешней линии поддержки и единой ответственности за интеграцию и железо; в Казахстане такие задачи часто закрывают через системного интегратора и производителя вроде GSE.kz.
