7 мин
Bare metal provisioning для серверов: Foreman, MAAS, Cobbler
Bare metal provisioning помогает быстрее вводить серверы в эксплуатацию. Разберем признаки окупаемости, сравним Foreman, MAAS и Cobbler, и дадим план пилота.
Где теряется время при вводе серверов в эксплуатацию
Больше всего времени уходит не на установку ОС, а на десятки шагов вокруг нее. Пока сервер превращается из «железа в стойке» в готовый узел, инженеры постоянно переключаются между задачами, доступами и согласованиями.
Чаще всего часы съедают одни и те же вещи: сеть (VLAN, IP, DNS, шлюзы, доступ в нужные сегменты, PXE), учетные записи и ключи, базовая защита и обновления, правильная подготовка образа (версия ОС, драйверы, RAID, UEFI/BIOS), а также учет и фиксация данных (серийники, инвентарник, владелец, где стоит и к чему подключен).
Ручная установка почти всегда дает разный результат у разных инженеров. Один ставит пакеты «на всякий случай», другой забывает про NTP или sysctl, третий называет интерфейсы по-своему. Через пару недель это превращается в вопрос «почему этот сервер не как остальные», а поиск отличий занимает дольше, чем правильная сборка с нуля.
Важно понимать и границы: bare metal provisioning обычно закрывает повторяемые шаги до уровня «сервер с ОС и базовой конфигурацией». Он не заменяет мониторинг, бэкапы и развертывание приложений, но может передать дальше «эстафету», уже подготовив теги, переменные и базовые агенты.
Еще один источник задержек - люди и очереди. В цепочке участвуют платформа и сети, эксплуатация (стойка, питание), безопасность (доступы и требования), иногда закупки и владельцы систем. Если шаги не формализованы, каждый новый сервер становится мини-проектом. Именно здесь автоматизация ввода серверов в эксплуатацию дает самый заметный выигрыш.
Что такое bare metal provisioning простыми словами
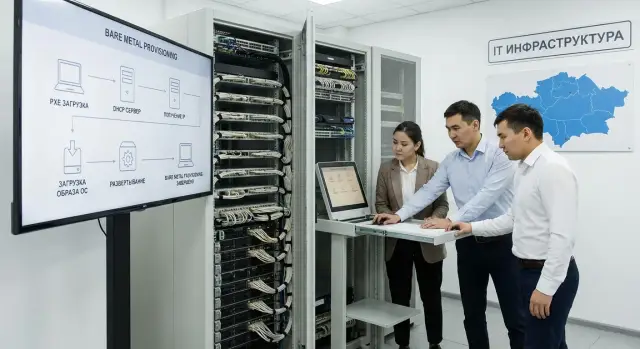
Bare metal provisioning - это когда физический сервер получает операционную систему и базовые настройки автоматически: без флешки и без длинного чек-листа. Сервер включили, и через заданное время он уже в нужной ОС, с сетевыми параметрами, ключами доступа и базовым набором пакетов.
Обычно это выглядит так: сервер загружается по сети и получает инструкции, что ставить и как настраивать. Установка идет по шаблону, а после первого запуска выполняются команды, которые доводят систему до нужного состояния.
В типовой схеме участвуют DHCP (выдает адрес и параметры), PXE (запускает загрузку), файл автоустановки для инсталлятора ОС и post-install скрипты (агенты, политики, базовые настройки). В конце сервер регистрируется в учете как готовый.
Главная идея - стандартизация. Вместо того чтобы каждый раз решать, «что поставить на этот сервер», вы описываете роли (например, гипервизор, база данных, сервер приложений), профили и теги, а затем применяете их к конкретному железу. Это удобно, когда у вас много одинаковых серверов в стойках или когда важно строгое соответствие внутренним стандартам.
Какие риски это снимает? В первую очередь человеческий фактор: забытые шаги, разные версии настроек, пропущенные требования безопасности. Во вторую - расхождение с правилами: кто-то настроил сеть «как обычно», а не «как принято». В итоге ввод серверов в эксплуатацию становится повторяемым и предсказуемым.
Когда автоматизация реально ускоряет, а когда нет
Автоматизация дает максимум там, где вы снова и снова делаете одно и то же: поставить ОС, задать сеть, добавить ключи, установить базовые пакеты, отметить в учете. Bare metal provisioning убирает ручные шаги и делает результат одинаковым каждый раз.
Сильнее всего эффект заметен, когда одновременно есть объем, повторяемость и требования к контролю. Даже если серверов немного, но они запускаются «рывками» под проекты или сезонную нагрузку, автоматизация часто спасает сроки.
Она обычно ускоряет, если:
- серверов много в месяц, или вы вводите их «волнами»;
- есть типовые роли (виртуализация, БД, приложения, VDI) и понятные шаблоны;
- сеть сложная (несколько подсетей, VLAN, изолированные сегменты), а выдача IP и имен должна быть аккуратной;
- важны безопасность и аудит: нужно понимать, кто и когда ставил образ и какие параметры применились;
- есть удаленные площадки, где рядом нет опытного инженера.
А вот когда ускорение слабое, проблема чаще всего не в инструментах, а в исходных данных и процессе. Если каждый сервер уникален, решения принимаются «по месту», а сеть каждый раз собирается заново, вы упретесь в согласования и переделки.
Обычно не стоит ждать чуда, если:
- серверы вводятся редко (пара штук в квартал) и процесс уже отлажен;
- роли и требования постоянно меняются и не зафиксированы;
- нет контроля над DHCP/DNS/сегментацией и нельзя обеспечить стабильный PXE;
- безопасность запрещает автоустановку без заранее утвержденных образов и процедур.
Практичный ориентир простой: автоматизация окупается, когда вы готовы описать «как должно быть» в виде шаблона. Тогда один раз настраиваете процесс, а дальше повторяете его десятки раз.
Признаки, что provisioning окупится: простые метрики
Чтобы понять, стоит ли вкладываться в bare metal provisioning, не нужно гадать. Достаточно пару недель честно померить, сколько времени уходит на ввод одного сервера и где вы теряете темп.
3 метрики, которые быстро показывают эффект
Начните с простого учета по каждому серверу (хотя бы в таблице):
- Время до готовности: от распаковки и подключения до момента, когда сервер в нужной ОС и готов принять нагрузку.
- Количество переделок: сколько раз переустанавливали ОС, правили драйверы, меняли сетевые параметры, пересоздавали RAID.
- Время ожиданий: сколько часов или дней уходит на доступы, согласования, вручную выданные IP, VLAN, учетные записи.
Если по этим пунктам набирается много «пустого» времени, автоматизация ввода серверов в эксплуатацию почти всегда дает быстрый выигрыш.
Окупаемость появляется там, где есть повторяемость. Например, у вас 3-5 типовых ролей (виртуализация, база данных, приложения, VDI, резервное копирование), и парк растет. Еще сильный сигнал - требования аудита: нужно доказуемо показывать, что серверы поднимаются одинаково, с понятной историей изменений и без «ручных магических настроек».
Если вы ставите 1-2 сервера в квартал и каждый раз конфигурация уникальна, внедрение может не отбиться: слишком много исключений, а шаблоны почти не переиспользуются.
Foreman, MAAS и Cobbler: чем отличаются на практике
Все три инструмента решают одну задачу: поставить ОС на физический сервер без ручных шагов, обычно через PXE. Но на практике они отличаются тем, насколько глубоко берут на себя управление жизненным циклом хоста и сколько усилий нужно на поддержку.
Foreman чаще выбирают, когда provisioning - часть более широкого процесса. Его сильная сторона - шаблоны развертывания, хост-группы и предсказуемость: вы описываете классы серверов (гипервизор, БД, приложение), и каждый новый хост получает одинаковые настройки. Это удобно, когда важно не просто поставить ОС, а закрепить стандарты.
MAAS сильнее в работе с железом и переиспользовании серверов. Он хорошо подходит, если важны инвентаризация, быстрое переприсвоение сервера роли и частый re-provisioning (тестовые кластеры, временные стенды, быстрое расширение пула). Его можно воспринимать как систему, которая держит парк «в готовности» и быстро выдает узлы под задачи.
Cobbler часто выбирают за простоту: легковесный PXE и базовые сценарии с минимумом компонентов. Он подходит, когда нужно быстро закрыть понятную потребность, но часть логики (учет ролей, контроль стандартов, аудит) обычно остается вне Cobbler.
Перед выбором проверьте базовые ограничения: UEFI, драйверы для сетевых карт и RAID/HBA, удаленное управление через IPMI или Redfish, а также как будет устроен каталог образов и их обновление. Для bare metal provisioning это часто важнее «любимого инструмента».
Чтобы избежать религиозных споров, сравнивайте по сценариям: сколько ролей нужно поддерживать, как часто вы переустанавливаете железо, какие требования к аудиту и повторяемости, насколько разнородный парк, и кто будет это сопровождать.
Что нужно подготовить до старта: сети, доступы, образы, роли
Перед тем как включать Foreman, MAAS или Cobbler, важно собрать базу. Большинство провалов пилота случается не из-за выбора инструмента, а из-за неподготовленной сети, отсутствия доступа к «железу» и разрозненных образов ОС.
Начните с provisioning-сети. Идеально - отдельный VLAN или физически отдельная сеть для PXE и сервисов установки. Если изолировать нельзя, заранее договоритесь о правилах: где включен DHCP, какие подсети участвуют, и как исключить «случайную» раздачу адресов рабочим сегментам.
Дальше нужны базовые сервисы: DHCP, TFTP или HTTP для загрузки, DNS (хотя бы для имен узлов), репозитории пакетов и NTP. Один «плавающий» источник времени потом ломает логи и расследования, поэтому NTP лучше считать обязательным.
Отдельный блок - доступ к серверам. Для настоящего bare metal provisioning обычно нужны IPMI или Redfish, чтобы включать питание, управлять загрузкой и читать состояние. В крупных организациях это быстро упирается в безопасность: кто создает учетные записи, где хранятся пароли, какие команды разрешены, кто имеет доступ к консоли.
Чтобы пилот был честным, подготовьте минимум: 2-3 роли, правила именования и сетевых параметров для каждой роли, один стандарт разметки дисков и базовых настроек, а также ответственных - кто утверждает роль и кто принимает результат.
По образам ОС заранее договоритесь о версиях и обновлениях: кто собирает новый образ, как он тестируется и как фиксируется точная версия, чтобы через месяц можно было повторить установку один в один. И сразу продумайте журналирование: какой сервер ставили, когда, каким шаблоном, и что получилось.
План пилота на 2-4 недели: шаг за шагом
Пилот нужен не для того, чтобы сразу охватить весь парк, а чтобы доказать три вещи: время сокращается, результат повторяемый, ручных ошибок меньше. Поэтому берите одну площадку (один зал или один сегмент сети) и 1-2 типовые роли, которые ставятся чаще всего.
Заранее договоритесь о критериях успеха: время от включения до готового сервера, доля установок без ручных правок, сколько раз «падает» установка, как быстро можно пересобрать сервер после сбоя.
Недели 1-2: поднять минимальный рабочий поток
Соберите цепочку: PXE-загрузка - установка ОС - post-install (сеть, учетные записи, агент мониторинга, базовые пакеты). Один и тот же профиль должен давать одинаковый результат на одинаковом железе.
Затем подключите управление питанием и сбор инвентаризации. Это экономит время на походы в серверную и помогает ловить несовпадения по дискам, сетевым картам и прошивкам еще до установки.
Недели 3-4: прогон и приемка
Сделайте серию однотипных установок подряд и фиксируйте цифры:
- 5-10 установок одной роли на одинаковых серверах
- замер времени по этапам (PXE, установка, post-install)
- все ручные вмешательства с причиной
- число повторных запусков и причины
- время на «восстановление с нуля»
После этого проведите короткую демонстрацию для эксплуатации и ИБ: где хранятся образы и секреты, как ведется аудит, кто может запускать пересборку.
Как измерить эффект пилота: критерии и цифры
Чтобы пилот не превратился в спор вкусов, заранее договоритесь о цифрах и точке отсчета. Самый честный вариант - взять 3-5 типовых серверов и установить их «по-старому», записав время и шаги, а затем повторить то же на пилоте.
Главный показатель - время до готовности: от включения железа до момента, когда сервер доступен по SSH или WinRM и на нем уже есть нужная базовая роль (агент мониторинга, доменная привязка, набор пакетов для гипервизора). Фиксируйте не только среднее, но и разброс: автоматизация ценна тем, что делает результат предсказуемым.
Для оценки качества удобно держать 5 метрик по каждой установке:
- время до готовности и «время оператора» (сколько минут человек реально делал руками)
- доля ручных действий (BIOS, RAID, сеть, постконфиг)
- надежность (процент установок без вмешательства и причины сбоев)
- повторяемость (совпадают ли пакеты, версии, сеть, политики на одинаковых серверах)
- восстановление (время на re-provision после замены диска или сбоя)
Отдельно проверьте прозрачность: по каждому запуску должны оставаться понятные логи и фактология. Это важно, если есть аудит, требования по изменениям или проекты для госсектора.
Пример ориентира по пилоту: если раньше инженер тратил 2-3 часа активного времени на один сервер, разумная цель - сократить «время оператора» до 10-20 минут, даже если полная установка занимает 40-90 минут.
Финальная оценка простая: (экономия минут оператора на сервер) x (серверов в месяц) = сколько часов возвращается команде. Если цифра заметна уже на пилоте, есть смысл масштабировать.
Типичные ошибки и ловушки при внедрении
Самые частые проблемы связаны с мелочами вокруг provisioning. Автоматизация дает скорость, но если базовые вещи не согласованы, вы получите быстрые, но повторяющиеся сбои.
Чаще всего всплывает следующее:
- Смешение сетей: provisioning-сеть видна из пользовательских сегментов. Это и риск безопасности, и источник случайных PXE-загрузок.
- UEFI и Secure Boot: часть серверов грузится по BIOS, часть по UEFI, ключи Secure Boot не подготовлены. Один и тот же шаблон то работает, то падает.
- Драйверы и RAID: установка проходит, но контроллер не в том режиме или драйвер подхватывается позже. Потом ловите низкую производительность, деградацию массива или странные перезагрузки.
- Слишком тяжелый post-install: в шаблон складывают все сразу (домен, мониторинг, бэкап, политики, десятки пакетов). Один внешний репозиторий подвис - и поток раскатки встал.
- Нет владельца процесса: образы и шаблоны меняют все понемногу, а отвечать за результат некому.
Помогают простые правила: provisioning-сеть изолирована, порядок загрузки и режим (UEFI или BIOS) единый для пилотной группы. По дискам заранее решите, где нужен RAID, где HBA, и проверьте это на одной машине под нагрузкой, а не только «чтобы установилось».
Шаблоны держите минимальными: ОС, сеть, доступ, базовые пакеты. Все остальное лучше добавлять отдельным этапом, который можно повторить или пропустить.
И продумайте откат. Если автозагрузка сломалась в разгар инцидента, должен быть задокументированный путь возврата к ручной установке и понятная точка, где вы переключаетесь обратно.
Короткий чек-лист перед запуском в прод
Перед тем как включать bare metal provisioning для реальных серверов, полезно остановиться на простых проверках. Они занимают день, но экономят недели разборов.
Безопасность и контроль доступа
Определите, кто и как управляет железом (BMC/iDRAC/iLO), коммутаторами и API инструмента provisioning. В проде не должно быть «общих» логинов.
- Разделите учетные записи для автоматизации и для людей, дайте минимально нужные права.
- Убедитесь, что доступ к питанию и консоли логируется.
- Разведите роли: кто редактирует шаблоны, кто запускает установку, кто подтверждает ввод сервера.
Сеть, шаблоны и воспроизводимость
Самая частая авария - «левый» DHCP/PXE, который перехватывает не ту машину.
- Проверьте, что DHCP/PXE работает только в нужном VLAN или сегменте.
- Введите контроль версий для шаблонов (kickstart/preseed/cloud-init) и зафиксируйте порядок обновления образов.
- Настройте журналы установок и хранение артефактов: какой шаблон, какие параметры, какой результат и на каком железе.
- Опишите сценарий отката: безопасная переустановка и быстрый возврат сервера в строй при сбое.
Также заранее договоритесь о приемке: кто забирает сервер после установки и по какому короткому чек-листу (доступ, имя хоста, диски/RAID, агент мониторинга, базовые политики).
Реалистичный пример: как это выглядит в обычном дата-центре
Типовая задача: за 10-14 дней нужно ввести 20 новых серверов под частное облако или VDI. Железо уже в пути, сеть в дата-центре есть, но команда маленькая и параллельно разбирает инциденты.
До автоматизации все держится на ручной установке. Один инженер ставит ОС, второй вручную настраивает RAID, третий правит сеть. Каждый раз всплывают мелочи: разные версии образов, забытые обновления, отличия в схеме разделов. В итоге сроки плавают: один сервер готов за 2 часа, другой - за день из-за переделок и очереди на людей.
После внедрения bare metal provisioning подход меняется. Появляется один утвержденный образ и 2-3 роли, например «гипервизор», «узел VDI», «сервер управления». Дальше процесс становится прямолинейным: создают заявку и выбирают роль, назначают профиль (сеть, диски, ключи), запускают автоустановку, принимают результат по чек-листу.
Часть работы все равно остается вручную: поставить сервер в стойку, подключить питание и сеть, промаркировать порты, иногда согласовать VLAN и адреса. Но главное меняется: люди перестают делать одно и то же 20 раз и начинают контролировать процесс, а не «собирать» каждый сервер заново.
Следующие шаги: как перейти от пилота к регулярной эксплуатации
Если пилот дал выигрыш по времени и снизил долю ручных ошибок, закрепите результат процессом.
Сначала выберите 1-2 сценария, которые реально повторяются: ввод новых узлов в кластер, переустановка после сбоя, массовая замена ОС. Под них зафиксируйте 2-3 метрики, которые вы будете вести всегда: время до готовности, доля установок без ручных правок, число инцидентов из-за конфигурации.
Дальше проверьте, что выбранный инструмент проходит ваши ограничения: загрузка (UEFI/Legacy), удаленное управление (IPMI/Redfish), изоляция сетей, требования безопасности к хранению секретов. Один и тот же provisioning бывает быстрым в тестовой сети и болезненным в проде, если не решены доступы и сегментация.
Зафиксируйте владельцев и обновления
Самое частое место, где все ломается через месяц, - образы и шаблоны. Назначьте владельца (или небольшую группу), у кого есть право менять образ ОС, шаблоны kickstart/preseed/cloud-init, пост-настройку, драйверы и firmware-пакеты. Договоритесь о ритме обновлений (например, раз в месяц) и понятном правиле отката.
Расширяйте поэтапно
Чтобы внедрение не превратилось в большой проект, расширяйтесь ступенями: добавьте еще одну роль на том же типе железа, затем подключите второй тип платформы (другой контроллер, другой NIC), перенесите процесс в штатные окна изменений и добавьте минимальные проверки (логирование, кто и когда запускал).
Если вы планируете обновление парка или закупку новых партий, имеет смысл заранее согласовать требования к BMC, сетевым картам и режимам загрузки. В Казахстане такие задачи часто закрывают совместно с производителями и интеграторами: например, GSE.kz поставляет серверы, рабочие станции и оказывает услуги системной интеграции, а также поддержки, что удобно, когда нужно не только купить железо, но и быстро довести его до повторяемого стандарта эксплуатации.
Частые вопросы
Что такое bare metal provisioning?
Bare metal provisioning автоматически ставит ОС и базовые настройки на физический сервер. Сервер загружается по сети, получает нужный образ, параметры сети, доступы и стартовые пакеты по заранее подготовленному шаблону.
Когда автоматизация ввода серверов действительно выгодна?
Он быстрее всего окупается при серийном вводе серверов, типовых ролях и строгих требованиях к настройкам. Если команда регулярно вручную задает сеть, RAID, ключи и пакеты, шаблоны заметно сокращают время оператора и число ошибок.
Какие метрики помогут оценить окупаемость?
Измерьте время от подключения сервера до готовности, число переустановок и часы ожидания доступов, IP-адресов или VLAN. Если эти потери повторяются на каждом сервере, пилот автоматизации обычно имеет смысл.
Чем Foreman, MAAS и Cobbler отличаются на практике?
Foreman удобен для шаблонов, хост-групп и стандартных ролей. MAAS подходит для частого перераспределения и переустановки физического железа. Cobbler выбирают для более простых PXE-сценариев, когда часть учета и контроля ведется отдельно.
Что нужно подготовить перед запуском provisioning?
Подготовьте отдельный VLAN или строго ограниченный сегмент для PXE, DHCP, DNS, источник времени и доступ к репозиториям. До старта также согласуйте IPMI или Redfish, правила именования, параметры сетей, разметку дисков и версии образов ОС.
Как провести пилот за 2-4 недели?
Начните с одной площадки, одной или двух частых ролей и нескольких одинаковых серверов. В первые две недели соберите цепочку PXE, установки ОС и базовой постнастройки, затем выполните 5-10 одинаковых установок и зафиксируйте все ручные вмешательства.
Как понять, что пилот прошел успешно?
Считайте не только полное время установки, но и минуты активной работы инженера. Полезно проверить долю запусков без ручных правок, совпадение настроек на одинаковых серверах, причины сбоев и скорость повторной установки после отказа.
Какие ошибки чаще всего ломают provisioning?
Часто проблемы создают DHCP или PXE в неверном сегменте, смешение UEFI и BIOS, неподходящие драйверы RAID или сетевых карт. Не перегружайте стартовый шаблон: оставьте в нем ОС, сеть, доступ и базовые пакеты, а тяжелые действия вынесите в отдельный этап.
Заменяет ли provisioning мониторинг и развертывание приложений?
Обычно нет. Provisioning готовит сервер до уровня ОС и базовой конфигурации. Мониторинг, резервное копирование, приложения и сложные политики лучше подключать после установки через отдельные инструменты и контролируемые сценарии.
Как безопасно запустить provisioning в продакшене?
Нужны раздельные учетные записи для людей и автоматизации, минимальные права, журналирование действий и понятные роли для изменения шаблонов и запуска установок. Также заранее опишите безопасный откат к ручной установке на случай сбоя автоматического потока.